

Stable Diffusion

Цитата: Андрей от 08.03.2023, 14:19Цитата: Евгений от 08.03.2023, 13:11По поводу трейна на LORA.
Датасет - 20 фото 512х512 , одна в полный рост и парочка в профиль, остальные близкий портрет. Настройки такие - https://mega.nz/file/ndFRwTIB#-T-6AKXtK8Xa8VZGzNAjARNUyGTj2qEYSLp7zePDOIs - только "train_batch_size": 2, изменил на 1. Хочу сразу уточнить что получить фотореалистичное изображение задачи не стояло, хотел просто разноплановые картинки с узнаваемым лицом человека на ком трейн был.
[spoiler title=""]<img class="lazyload" src="data:;base64," alt="" width="200" height="200" data-orig-src="https://i.imgur.com/Gy9gMQv.png" /><img class="lazyload" src="data:;base64," alt="" width="200" height="300" data-orig-src="https://i.imgur.com/NYcqTYO.jpg" /><img class="lazyload" src="data:;base64," alt="" width="200" height="198" data-orig-src="https://i.imgur.com/4Am9IHG.jpg" /><img class="lazyload" src="data:;base64," alt="" width="200" height="200" data-orig-src="https://i.imgur.com/udNGxd0.png" />[/spoiler]
Фото самой модели [spoiler title=""]<img class="lazyload" src="data:;base64," alt="" width="200" height="143" data-orig-src="https://i.imgur.com/4HyZBkq.jpg" />[/spoiler]
С поставленной мной задачей лора справляется вполне, человек на генерируемых картинка похож на себя.
Есть конечно и минусы - в легкую губит кожу (CFG Scale нужно урезать до 5 и меньше) и вариации фонов получаются однотонные какие то.
Поиграться с вариациями настроек и можно получить не плохие результаты.
С гиперсетью сравнить пока не могу так как только пару дней назад получилось натренировать ее удовлетворительный результат. Позже сравню.
Я сейчас тоже тренирую Лору. Задача- получить полный реализм. Результаты хорошие, но ещё не идеально. Буду параметры менять, экспериментировать. По ощущениям эффективнее, чем гиперсеть. Не прям сильно лучше, но легче всё даётся) Окончательный вердикт вынесу через месяц. Погоняю всё и решу, как лучше всего для меня будет
Цитата: Евгений от 08.03.2023, 13:11По поводу трейна на LORA.
Датасет - 20 фото 512х512 , одна в полный рост и парочка в профиль, остальные близкий портрет. Настройки такие - https://mega.nz/file/ndFRwTIB#-T-6AKXtK8Xa8VZGzNAjARNUyGTj2qEYSLp7zePDOIs - только "train_batch_size": 2, изменил на 1. Хочу сразу уточнить что получить фотореалистичное изображение задачи не стояло, хотел просто разноплановые картинки с узнаваемым лицом человека на ком трейн был.
Спойлер<img class="lazyload" src="data:;base64," alt="" width="200" height="200" data-orig-src="https://i.imgur.com/Gy9gMQv.png" style="color: #25d39d !important" /><img class="lazyload" src="data:;base64," alt="" width="200" height="300" data-orig-src="https://i.imgur.com/NYcqTYO.jpg" style="color: #25d39d !important" /><img class="lazyload" src="data:;base64," alt="" width="200" height="198" data-orig-src="https://i.imgur.com/4Am9IHG.jpg" style="color: #25d39d !important" /><img class="lazyload" src="data:;base64," alt="" width="200" height="200" data-orig-src="https://i.imgur.com/udNGxd0.png" style="color: #25d39d !important" />Фото самой модели
Спойлер<img class="lazyload" src="data:;base64," alt="" width="200" height="143" data-orig-src="https://i.imgur.com/4HyZBkq.jpg" style="color: #25d39d !important" />С поставленной мной задачей лора справляется вполне, человек на генерируемых картинка похож на себя.
Есть конечно и минусы - в легкую губит кожу (CFG Scale нужно урезать до 5 и меньше) и вариации фонов получаются однотонные какие то.
Поиграться с вариациями настроек и можно получить не плохие результаты.
С гиперсетью сравнить пока не могу так как только пару дней назад получилось натренировать ее удовлетворительный результат. Позже сравню.
Я сейчас тоже тренирую Лору. Задача- получить полный реализм. Результаты хорошие, но ещё не идеально. Буду параметры менять, экспериментировать. По ощущениям эффективнее, чем гиперсеть. Не прям сильно лучше, но легче всё даётся) Окончательный вердикт вынесу через месяц. Погоняю всё и решу, как лучше всего для меня будет
Цитата: Андрей от 08.03.2023, 14:28Цитата: Sergey от 08.03.2023, 02:45CUDA out of memory.
Добрый вечерю Ничего не предвещало - трейн перестал работать. при попытке запуска обработка датасета проходит следом вылетают ошибки - код под спойлером.
Ничего не менял, ничего не подключал. Помогите, люди добрые:([spoiler title=""]tPreparing dataset...
100%|██████████████████████████████████████████████████████████████████████████████████| 28/28 [00:05<00:00, 5.06it/s]
0%| | 0/10000 [00:00<?, ?it/s]Traceback (most recent call last):
File "E:\stable-diffusion-portable-main\modules\hypernetworks\hypernetwork.py", line 655, in train_hypernetwork
loss = shared.sd_model.forward(x, c)[0] / gradient_step
File "E:\stable-diffusion-portable-main\repositories\stable-diffusion-stability-ai\ldm\models\diffusion\ddpm.py", line 846, in forward
return self.p_losses(x, c, t, *args, **kwargs)
File "E:\stable-diffusion-portable-main\repositories\stable-diffusion-stability-ai\ldm\models\diffusion\ddpm.py", line 886, in p_losses
model_output = self.apply_model(x_noisy, t, cond)
File "E:\stable-diffusion-portable-main\modules\sd_hijack_utils.py", line 17, in <lambda>
setattr(resolved_obj, func_path[-1], lambda *args, **kwargs: self(*args, **kwargs))
File "E:\stable-diffusion-portable-main\modules\sd_hijack_utils.py", line 28, in __call__
return self.__orig_func(*args, **kwargs)
File "E:\stable-diffusion-portable-main\repositories\stable-diffusion-stability-ai\ldm\models\diffusion\ddpm.py", line 858, in apply_model
x_recon = self.model(x_noisy, t, **cond)
File "E:\stable-diffusion-portable-main\venv\lib\site-packages\torch\nn\modules\module.py", line 1194, in _call_impl
return forward_call(*input, **kwargs)
File "E:\stable-diffusion-portable-main\repositories\stable-diffusion-stability-ai\ldm\models\diffusion\ddpm.py", line 1329, in forward
out = self.diffusion_model(x, t, context=cc)
File "E:\stable-diffusion-portable-main\venv\lib\site-packages\torch\nn\modules\module.py", line 1194, in _call_impl
return forward_call(*input, **kwargs)
File "E:\stable-diffusion-portable-main\repositories\stable-diffusion-stability-ai\ldm\modules\diffusionmodules\openaimodel.py", line 776, in forward
h = module(h, emb, context)
File "E:\stable-diffusion-portable-main\venv\lib\site-packages\torch\nn\modules\module.py", line 1194, in _call_impl
return forward_call(*input, **kwargs)
File "E:\stable-diffusion-portable-main\repositories\stable-diffusion-stability-ai\ldm\modules\diffusionmodules\openaimodel.py", line 84, in forward
x = layer(x, context)
File "E:\stable-diffusion-portable-main\venv\lib\site-packages\torch\nn\modules\module.py", line 1194, in _call_impl
return forward_call(*input, **kwargs)
File "E:\stable-diffusion-portable-main\repositories\stable-diffusion-stability-ai\ldm\modules\attention.py", line 324, in forward
x = block(x, context=context[i])
File "E:\stable-diffusion-portable-main\venv\lib\site-packages\torch\nn\modules\module.py", line 1194, in _call_impl
return forward_call(*input, **kwargs)
File "E:\stable-diffusion-portable-main\modules\sd_hijack_checkpoint.py", line 8, in BasicTransformerBlock_forward
return checkpoint(self._forward, x, context)
File "E:\stable-diffusion-portable-main\venv\lib\site-packages\torch\utils\checkpoint.py", line 249, in checkpoint
return CheckpointFunction.apply(function, preserve, *args)
File "E:\stable-diffusion-portable-main\venv\lib\site-packages\torch\utils\checkpoint.py", line 107, in forward
outputs = run_function(*args)
File "E:\stable-diffusion-portable-main\repositories\stable-diffusion-stability-ai\ldm\modules\attention.py", line 262, in _forward
x = self.attn1(self.norm1(x), context=context if self.disable_self_attn else None) + x
File "E:\stable-diffusion-portable-main\venv\lib\site-packages\torch\nn\modules\module.py", line 1194, in _call_impl
return forward_call(*input, **kwargs)
File "E:\stable-diffusion-portable-main\modules\hypernetworks\hypernetwork.py", line 418, in attention_CrossAttention_forward
attn = sim.softmax(dim=-1)
torch.cuda.OutOfMemoryError: CUDA out of memory. Tried to allocate 8.00 GiB (GPU 0; 12.00 GiB total capacity; 5.88 GiB already allocated; 3.83 GiB free; 5.96 GiB reserved in total by PyTorch) If reserved memory is >> allocated memory try setting max_split_size_mb to avoid fragmentation. See documentation for Memory Management and PYTORCH_CUDA_ALLOC_CONFApplying xformers cross attention optimization.[/spoiler]
https://win10tweaker.ru/forum/topic/stable-diffusion?part=63
тут вроде было похожее, попробуйте сделать то, что помогло другому человеку
Цитата: Sergey от 08.03.2023, 02:45CUDA out of memory.
Добрый вечерю Ничего не предвещало - трейн перестал работать. при попытке запуска обработка датасета проходит следом вылетают ошибки - код под спойлером.
Ничего не менял, ничего не подключал. Помогите, люди добрые:(СпойлерtPreparing dataset...
100%|██████████████████████████████████████████████████████████████████████████████████| 28/28 [00:05<00:00, 5.06it/s]
0%| | 0/10000 [00:00<?, ?it/s]Traceback (most recent call last):
File "E:\stable-diffusion-portable-main\modules\hypernetworks\hypernetwork.py", line 655, in train_hypernetwork
loss = shared.sd_model.forward(x, c)[0] / gradient_step
File "E:\stable-diffusion-portable-main\repositories\stable-diffusion-stability-ai\ldm\models\diffusion\ddpm.py", line 846, in forward
return self.p_losses(x, c, t, *args, **kwargs)
File "E:\stable-diffusion-portable-main\repositories\stable-diffusion-stability-ai\ldm\models\diffusion\ddpm.py", line 886, in p_losses
model_output = self.apply_model(x_noisy, t, cond)
File "E:\stable-diffusion-portable-main\modules\sd_hijack_utils.py", line 17, in <lambda>
setattr(resolved_obj, func_path[-1], lambda *args, **kwargs: self(*args, **kwargs))
File "E:\stable-diffusion-portable-main\modules\sd_hijack_utils.py", line 28, in __call__
return self.__orig_func(*args, **kwargs)
File "E:\stable-diffusion-portable-main\repositories\stable-diffusion-stability-ai\ldm\models\diffusion\ddpm.py", line 858, in apply_model
x_recon = self.model(x_noisy, t, **cond)
File "E:\stable-diffusion-portable-main\venv\lib\site-packages\torch\nn\modules\module.py", line 1194, in _call_impl
return forward_call(*input, **kwargs)
File "E:\stable-diffusion-portable-main\repositories\stable-diffusion-stability-ai\ldm\models\diffusion\ddpm.py", line 1329, in forward
out = self.diffusion_model(x, t, context=cc)
File "E:\stable-diffusion-portable-main\venv\lib\site-packages\torch\nn\modules\module.py", line 1194, in _call_impl
return forward_call(*input, **kwargs)
File "E:\stable-diffusion-portable-main\repositories\stable-diffusion-stability-ai\ldm\modules\diffusionmodules\openaimodel.py", line 776, in forward
h = module(h, emb, context)
File "E:\stable-diffusion-portable-main\venv\lib\site-packages\torch\nn\modules\module.py", line 1194, in _call_impl
return forward_call(*input, **kwargs)
File "E:\stable-diffusion-portable-main\repositories\stable-diffusion-stability-ai\ldm\modules\diffusionmodules\openaimodel.py", line 84, in forward
x = layer(x, context)
File "E:\stable-diffusion-portable-main\venv\lib\site-packages\torch\nn\modules\module.py", line 1194, in _call_impl
return forward_call(*input, **kwargs)
File "E:\stable-diffusion-portable-main\repositories\stable-diffusion-stability-ai\ldm\modules\attention.py", line 324, in forward
x = block(x, context=context[i])
File "E:\stable-diffusion-portable-main\venv\lib\site-packages\torch\nn\modules\module.py", line 1194, in _call_impl
return forward_call(*input, **kwargs)
File "E:\stable-diffusion-portable-main\modules\sd_hijack_checkpoint.py", line 8, in BasicTransformerBlock_forward
return checkpoint(self._forward, x, context)
File "E:\stable-diffusion-portable-main\venv\lib\site-packages\torch\utils\checkpoint.py", line 249, in checkpoint
return CheckpointFunction.apply(function, preserve, *args)
File "E:\stable-diffusion-portable-main\venv\lib\site-packages\torch\utils\checkpoint.py", line 107, in forward
outputs = run_function(*args)
File "E:\stable-diffusion-portable-main\repositories\stable-diffusion-stability-ai\ldm\modules\attention.py", line 262, in _forward
x = self.attn1(self.norm1(x), context=context if self.disable_self_attn else None) + x
File "E:\stable-diffusion-portable-main\venv\lib\site-packages\torch\nn\modules\module.py", line 1194, in _call_impl
return forward_call(*input, **kwargs)
File "E:\stable-diffusion-portable-main\modules\hypernetworks\hypernetwork.py", line 418, in attention_CrossAttention_forward
attn = sim.softmax(dim=-1)
torch.cuda.OutOfMemoryError: CUDA out of memory. Tried to allocate 8.00 GiB (GPU 0; 12.00 GiB total capacity; 5.88 GiB already allocated; 3.83 GiB free; 5.96 GiB reserved in total by PyTorch) If reserved memory is >> allocated memory try setting max_split_size_mb to avoid fragmentation. See documentation for Memory Management and PYTORCH_CUDA_ALLOC_CONFApplying xformers cross attention optimization.
https://win10tweaker.ru/forum/topic/stable-diffusion?part=63
тут вроде было похожее, попробуйте сделать то, что помогло другому человеку

Цитата: Дмитрий от 08.03.2023, 14:39Подскажите пожалуйста, в момент генерации изображений в Stable Diffusion Portable (ставил по вашему видео) почти постоянно появляется ошибка:
A tensor with all NaNs was produced in Unet. This could be either because there's not enough precision to represent the picture, or because your video card does not support half type. Try setting the "Upcast cross attention layer to float32" option in Settings > Stable Diffusion or using the --no-half commandline argument to fix this. Use --disable-nan-check commandline argument to disable this check.Такой ошибки нет в stable-diffusion-ui. С чем это может быть связано?
Видеокарта: MSI GTX 1070 Gaming X (MS-V330).
Процессор: QuadCore Intel Xeon E3-1270 v3, 3700 MHz (37 x 100)
Оперативки: 24Гб.Из 10 попыток парочку изображений сгенерирует, и при размерах 512х512. Большее вообще не генерирует.
Мне понравилась эта сборка, хотел попробовать Train но почему то вот такая ошибка появляется постоянно.
Подскажите пожалуйста, в момент генерации изображений в Stable Diffusion Portable (ставил по вашему видео) почти постоянно появляется ошибка:
СкопированоA tensor with all NaNs was produced in Unet. This could be either because there's not enough precision to represent the picture, or because your video card does not support half type. Try setting the "Upcast cross attention layer to float32" option in Settings > Stable Diffusion or using the --no-half commandline argument to fix this. Use --disable-nan-check commandline argument to disable this check.Такой ошибки нет в stable-diffusion-ui. С чем это может быть связано?
Видеокарта: MSI GTX 1070 Gaming X (MS-V330).
Процессор: QuadCore Intel Xeon E3-1270 v3, 3700 MHz (37 x 100)
Оперативки: 24Гб.
Из 10 попыток парочку изображений сгенерирует, и при размерах 512х512. Большее вообще не генерирует.
Мне понравилась эта сборка, хотел попробовать Train но почему то вот такая ошибка появляется постоянно.

Цитата: Сергей от 08.03.2023, 15:03Цитата: Slava от 08.03.2023, 00:26Цитата: Сергей от 07.03.2023, 18:50Добра)
Скажите, а как можно расширить изображение сгенерированное нейросеткой, при помощи нейросетки?))) Я пытался делать так, как учили в видео, но ничего не выходит. Не выходит по тому, что я не могу задать нужный промт.
Картинка 1
<img class="lazyload " src="data:;base64," alt="----картинка 1-----" width="161" height="161" data-orig-src="https://i.ibb.co/NSjCFKB/00013-20230302125946.png" />
Картинка получилась в результате совокупления двух промтов : [girl:boy:10] все.Но арт получился красивый и я хотел сделать его на рабочку, для чего попытался расшить его примерно до 2500 х1400 в img2img. Но так как я представления не имею что это у девушки вместо волос, я не могу ввести нужный промт.
Получается одна фигня.
Картинка 2
<img class="lazyload " src="data:;base64," alt="----картинка 2-----" width="178" height="146" data-orig-src="https://i.ibb.co/gmcZh27/00203-20230307202246.png" />Перебрал кучу промтов и даже пытался довериться самой сетке, не указывая вообще ничего, мол, сама додумай. Додумывала хреново. Не так, как надо.
А мне нужно что бы картинка смотртелась гармонично и края ее (расширяемые) были логическим продолжением исходника.
В общем.. Помощи прошу)) Научите расскажите объясните )))
Спасибо))
Без промта с негативами у меня крылья бабочек начинает дорисовывать при увеличении) [spoiler title=""]
[/spoiler]
Выглядит, кстати, весьма прикольно))
Но меня все же интересует как можно расширить изображение в стороны, сохранив при этом контент
 [/spoiler]
Цитата: Slava от 08.03.2023, 00:26Цитата: Сергей от 07.03.2023, 18:50Добра)
Скажите, а как можно расширить изображение сгенерированное нейросеткой, при помощи нейросетки?))) Я пытался делать так, как учили в видео, но ничего не выходит. Не выходит по тому, что я не могу задать нужный промт.
Картинка 1
<img class="lazyload " src="data:;base64," alt="----картинка 1-----" width="161" height="161" data-orig-src="https://i.ibb.co/NSjCFKB/00013-20230302125946.png" style="color: #25d39d !important" />
Картинка получилась в результате совокупления двух промтов : [girl:boy:10] все.Но арт получился красивый и я хотел сделать его на рабочку, для чего попытался расшить его примерно до 2500 х1400 в img2img. Но так как я представления не имею что это у девушки вместо волос, я не могу ввести нужный промт.
Получается одна фигня.
Картинка 2
<img class="lazyload " src="data:;base64," alt="----картинка 2-----" width="178" height="146" data-orig-src="https://i.ibb.co/gmcZh27/00203-20230307202246.png" style="color: #25d39d !important" />Перебрал кучу промтов и даже пытался довериться самой сетке, не указывая вообще ничего, мол, сама додумай. Додумывала хреново. Не так, как надо.
А мне нужно что бы картинка смотртелась гармонично и края ее (расширяемые) были логическим продолжением исходника.
В общем.. Помощи прошу)) Научите расскажите объясните )))
Спасибо))
Без промта с негативами у меня крылья бабочек начинает дорисовывать при увеличении)
Спойлер
Выглядит, кстати, весьма прикольно))
Но меня все же интересует как можно расширить изображение в стороны, сохранив при этом контент

Цитата: Svetlana от 08.03.2023, 18:08Добрый день! У меня в скриптах появился controlnet 2m2, на GitHub не нашла описания...Или он сопутствует расширению Controlnet, в общем не поняла, откуда он взялся и что с ним делать))
Добрый день! У меня в скриптах появился controlnet 2m2, на GitHub не нашла описания...Или он сопутствует расширению Controlnet, в общем не поняла, откуда он взялся и что с ним делать))

Цитата: NiK от 08.03.2023, 21:28Добрый вечер! На GitHub обнаружен плагин, встраивающий Stable Diffusion в Photoshop.
Называется Auto-Photoshop-StableDiffusion-Plugin
Хочется детальный обзор от XpucT 🙂
Добрый вечер! На GitHub обнаружен плагин, встраивающий Stable Diffusion в Photoshop.
Называется Auto-Photoshop-StableDiffusion-Plugin
Хочется детальный обзор от XpucT 🙂

Цитата: Сергей от 08.03.2023, 21:31NiK, приветствую 🖐
Встраивать Stable Diffusion в другие программы не нужно.
Хачатур об этом говорил в видео.
NiK, приветствую 🖐
Встраивать Stable Diffusion в другие программы не нужно.
Хачатур об этом говорил в видео.

Цитата: Александр от 08.03.2023, 22:09[spoiler title=""]
Installing requirements for Web UI
Launching Web UI with arguments: --xformers --autolaunch
Checkpoint f222.ckpt [44bf0551] not found; loading fallback Deliberate_v2.safetensors
Calculating sha256 for D:\Stable\models\Stable-diffusion\Deliberate_v2.safetensors: 9aba26abdfcd46073e0a1d42027a3a3bcc969f562d58a03637bf0a0ded6586c9
Loading weights [9aba26abdf] from D:\Stable\models\Stable-diffusion\Deliberate_v2.safetensors
Creating model from config: D:\Stable\configs\v1-inference.yaml
LatentDiffusion: Running in eps-prediction mode
DiffusionWrapper has 859.52 M params.
Downloading (…)olve/main/vocab.json: 100%|██████████████████████████████████████████| 961k/961k [00:00<00:00, 1.48MB/s]
Downloading (…)olve/main/merges.txt: 100%|██████████████████████████████████████████| 525k/525k [00:00<00:00, 1.00MB/s]
Downloading (…)cial_tokens_map.json: 100%|█████████████████████████████████████████████| 389/389 [00:00<00:00, 260kB/s]
Downloading (…)okenizer_config.json: 100%|████████████████████████████████████████████| 905/905 [00:00<00:00, 1.21MB/s]
Failed to create model quickly; will retry using slow method.
LatentDiffusion: Running in eps-prediction mode
DiffusionWrapper has 859.52 M params.
loading stable diffusion model: OSError
Traceback (most recent call last):
File "D:\Stable\webui.py", line 111, in initialize
modules.sd_models.load_model()
File "D:\Stable\modules\sd_models.py", line 406, in load_model
sd_model = instantiate_from_config(sd_config.model)
File "D:\Stable\repositories\stable-diffusion-stability-ai\ldm\util.py", line 79, in instantiate_from_config
return get_obj_from_str(config["target"])(**config.get("params", dict()))
File "D:\Stable\repositories\stable-diffusion-stability-ai\ldm\models\diffusion\ddpm.py", line 563, in __init__
self.instantiate_cond_stage(cond_stage_config)
File "D:\Stable\repositories\stable-diffusion-stability-ai\ldm\models\diffusion\ddpm.py", line 630, in instantiate_cond_stage
model = instantiate_from_config(config)
File "D:\Stable\repositories\stable-diffusion-stability-ai\ldm\util.py", line 79, in instantiate_from_config
return get_obj_from_str(config["target"])(**config.get("params", dict()))
File "D:\Stable\repositories\stable-diffusion-stability-ai\ldm\modules\encoders\modules.py", line 99, in __init__
self.tokenizer = CLIPTokenizer.from_pretrained(version)
File "D:\Stable\venv\lib\site-packages\transformers\tokenization_utils_base.py", line 1801, in from_pretrained
return cls._from_pretrained(
File "D:\Stable\venv\lib\site-packages\transformers\tokenization_utils_base.py", line 1849, in _from_pretrained
with open(tokenizer_config_file, encoding="utf-8") as tokenizer_config_handle:
OSError: [Errno 22] Invalid argument: 'tmp/.cache\\huggingface\\hub\\models--openai--clip-vit-large-patch14\\snapshots\\8d052a0f05efbaefbc9e8786ba291cfdf93e5bff\\tokenizer_config.json'
Stable diffusion model failed to load, exiting[/spoiler]Добрый вечер! Решил попользоваться этим чудом, сразу просмотрев канал увидел портативную версию. Перешел на Github, скачал портейбл от Хачатура, распаковал в папку Stable файлы из архива, запустил батник, как появилась папка models, закинул Deliberate который указан на той же странице Github с Stable Diffusion и получаю ошибку. К тому же, при "установке" в батнике есть фраза "[notice] A new release of pip available: 22.2.1 -> 23.0.1
[notice] To update, run: D:\Stable\venv\Scripts\python.exe -m pip install --upgrade pip" вопрос, мне оно нужно?
СкопированоInstalling requirements for Web UIСкопированоLaunching Web UI with arguments: --xformers --autolaunchСкопированоCheckpoint f222.ckpt [44bf0551] not found; loading fallback Deliberate_v2.safetensorsСкопированоCalculating sha256 for D:\Stable\models\Stable-diffusion\Deliberate_v2.safetensors: 9aba26abdfcd46073e0a1d42027a3a3bcc969f562d58a03637bf0a0ded6586c9СкопированоLoading weights [9aba26abdf] from D:\Stable\models\Stable-diffusion\Deliberate_v2.safetensorsСкопированоCreating model from config: D:\Stable\configs\v1-inference.yamlСкопированоLatentDiffusion: Running in eps-prediction modeСкопированоDiffusionWrapper has 859.52 M params.СкопированоDownloading (…)olve/main/vocab.json: 100%|██████████████████████████████████████████| 961k/961k [00:00<00:00, 1.48MB/s]СкопированоDownloading (…)olve/main/merges.txt: 100%|██████████████████████████████████████████| 525k/525k [00:00<00:00, 1.00MB/s]СкопированоDownloading (…)cial_tokens_map.json: 100%|█████████████████████████████████████████████| 389/389 [00:00<00:00, 260kB/s]СкопированоDownloading (…)okenizer_config.json: 100%|████████████████████████████████████████████| 905/905 [00:00<00:00, 1.21MB/s]СкопированоFailed to create model quickly; will retry using slow method.СкопированоLatentDiffusion: Running in eps-prediction modeСкопированоDiffusionWrapper has 859.52 M params.Скопированоloading stable diffusion model: OSErrorСкопированоTraceback (most recent call last):СкопированоFile "D:\Stable\webui.py", line 111, in initializeСкопированоmodules.sd_models.load_model()СкопированоFile "D:\Stable\modules\sd_models.py", line 406, in load_modelСкопированоsd_model = instantiate_from_config(sd_config.model)СкопированоFile "D:\Stable\repositories\stable-diffusion-stability-ai\ldm\util.py", line 79, in instantiate_from_configСкопированоreturn get_obj_from_str(config["target"])(**config.get("params", dict()))СкопированоFile "D:\Stable\repositories\stable-diffusion-stability-ai\ldm\models\diffusion\ddpm.py", line 563, in __init__Скопированоself.instantiate_cond_stage(cond_stage_config)СкопированоFile "D:\Stable\repositories\stable-diffusion-stability-ai\ldm\models\diffusion\ddpm.py", line 630, in instantiate_cond_stageСкопированоmodel = instantiate_from_config(config)СкопированоFile "D:\Stable\repositories\stable-diffusion-stability-ai\ldm\util.py", line 79, in instantiate_from_configСкопированоreturn get_obj_from_str(config["target"])(**config.get("params", dict()))СкопированоFile "D:\Stable\repositories\stable-diffusion-stability-ai\ldm\modules\encoders\modules.py", line 99, in __init__Скопированоself.tokenizer = CLIPTokenizer.from_pretrained(version)СкопированоFile "D:\Stable\venv\lib\site-packages\transformers\tokenization_utils_base.py", line 1801, in from_pretrainedСкопированоreturn cls._from_pretrained(СкопированоFile "D:\Stable\venv\lib\site-packages\transformers\tokenization_utils_base.py", line 1849, in _from_pretrainedСкопированоwith open(tokenizer_config_file, encoding="utf-8") as tokenizer_config_handle:СкопированоOSError: [Errno 22] Invalid argument: 'tmp/.cache\\huggingface\\hub\\models--openai--clip-vit-large-patch14\\snapshots\\8d052a0f05efbaefbc9e8786ba291cfdf93e5bff\\tokenizer_config.json'
СкопированоStable diffusion model failed to load, exiting
Добрый вечер! Решил попользоваться этим чудом, сразу просмотрев канал увидел портативную версию. Перешел на Github, скачал портейбл от Хачатура, распаковал в папку Stable файлы из архива, запустил батник, как появилась папка models, закинул Deliberate который указан на той же странице Github с Stable Diffusion и получаю ошибку. К тому же, при "установке" в батнике есть фраза "[notice] A new release of pip available: 22.2.1 -> 23.0.1
[notice] To update, run: D:\Stable\venv\Scripts\python.exe -m pip install --upgrade pip" вопрос, мне оно нужно?

Цитата: Dmitry от 08.03.2023, 22:11Добрый вечер, стоит последняя ваша версия, в скриптах нет hypernetwork. (скрин xyz плота https://imgur.com/a/5ylpWBO)
Добрый вечер, стоит последняя ваша версия, в скриптах нет hypernetwork. (скрин xyz плота https://imgur.com/a/5ylpWBO)



Цитата: Евгений от 09.03.2023, 01:44Цитата: Андрей от 08.03.2023, 14:19
Я сейчас тоже тренирую Лору. Задача- получить полный реализм. Результаты хорошие, но ещё не идеально. Буду параметры менять, экспериментировать. По ощущениям эффективнее, чем гиперсеть.
Я бы сказал что Lora это лайтовая версия гиперсети, можно быстро получить неплохие результаты. С гиперсетью я бился очень долго, все не получалось натренировать ее на модели, хотя все делал по инструкции от Хачатура. А с лорой с лету все получилось. Главный для меня минус гиперсети это то что надо два с лишним часа гонять видяху на максимальной нагрузке при температуре 85 градусов. Лора 12- 20 мин и готово.
По поводу эффективности - победил таки гиперсеть и получилось натренировать узнаваемое лицо модели, сказал видяхе - надо родная, терпи 🙂
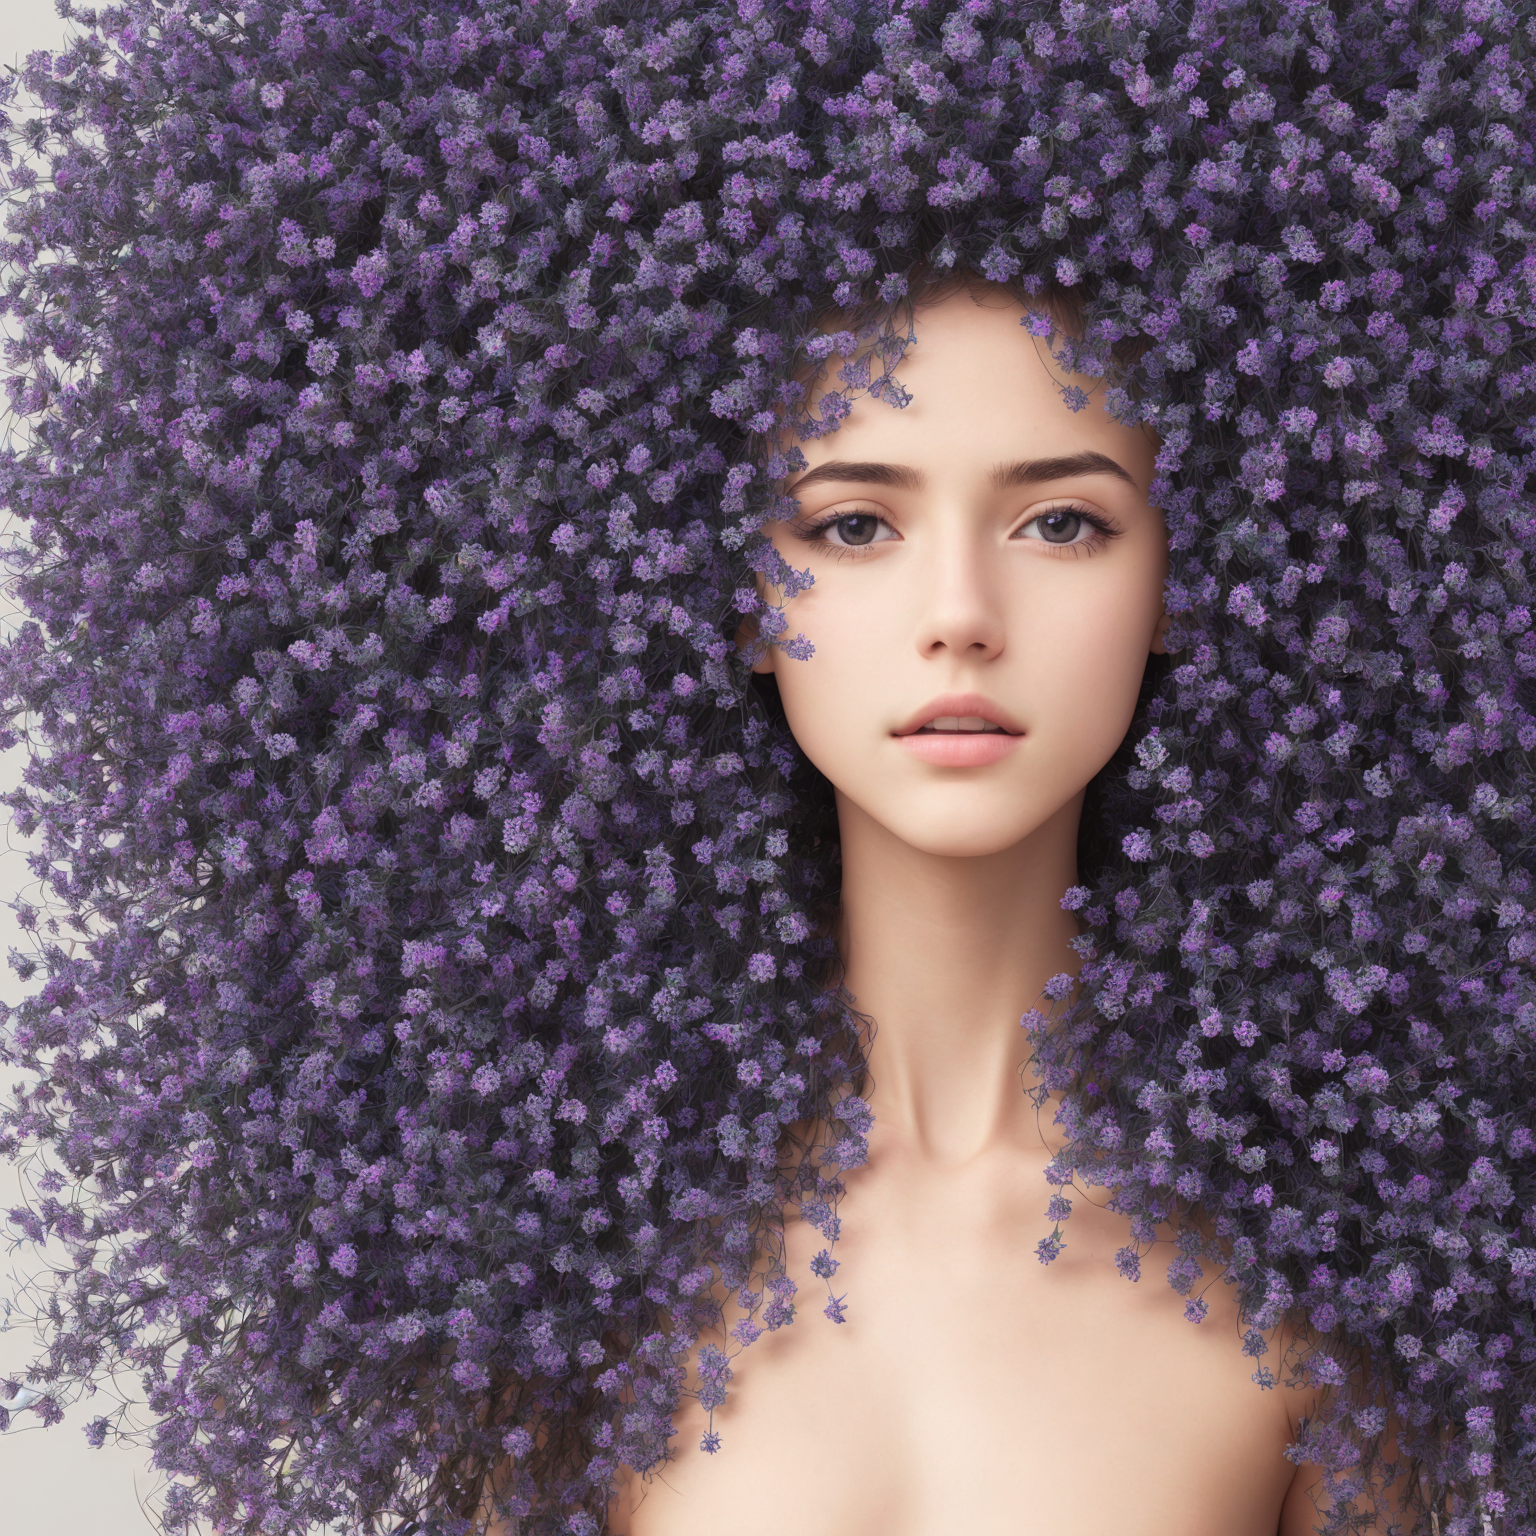
Если по чесноку - с художественной точки зрения мне результаты гиперсети больше нравятся, кожа однозначно лучше (если про реализм) и больше разнообразных фонов рисует, прически и цвет волос на лету меняет. У Лоры с этим проблемки.
[spoiler title=""]
[/spoiler]
Это гиперсеть, с Лорой у меня и близко не получалось подобное изображение получить.
Похоже на полный реализм? Реальное фото модели выше выкладывал.
Цитата: Андрей от 08.03.2023, 14:19
Я сейчас тоже тренирую Лору. Задача- получить полный реализм. Результаты хорошие, но ещё не идеально. Буду параметры менять, экспериментировать. По ощущениям эффективнее, чем гиперсеть.
Я бы сказал что Lora это лайтовая версия гиперсети, можно быстро получить неплохие результаты. С гиперсетью я бился очень долго, все не получалось натренировать ее на модели, хотя все делал по инструкции от Хачатура. А с лорой с лету все получилось. Главный для меня минус гиперсети это то что надо два с лишним часа гонять видяху на максимальной нагрузке при температуре 85 градусов. Лора 12- 20 мин и готово.
По поводу эффективности - победил таки гиперсеть и получилось натренировать узнаваемое лицо модели, сказал видяхе - надо родная, терпи 🙂
Если по чесноку - с художественной точки зрения мне результаты гиперсети больше нравятся, кожа однозначно лучше (если про реализм) и больше разнообразных фонов рисует, прически и цвет волос на лету меняет. У Лоры с этим проблемки.

Это гиперсеть, с Лорой у меня и близко не получалось подобное изображение получить.
Похоже на полный реализм? Реальное фото модели выше выкладывал.
Цитата: Евгений от 09.03.2023, 02:18Дополню
Есть такие ощущения (может они вообще не верны) Лора тупо использует маску глубины с фото что ей скормили и в момент генерации картинки рандомно подсовывает реальное фото с этой маской и именно по этому сложно получить различные вариации фонов, причесок и т.п, S.D пытается по промту нарисовать красиво но по маске глубины особо не разгуляешься и по этому часто получается разрушенная кожа лица.
А вот гиперсеть есть ощущение пытается создать именно 3D модель лица, и так как она не скована никакой маской получаются более реалистичные и вариативные изображения.
У меня есть фотосет коллеги, в студии снимали. Там более 100 портретных снимков в разных ракурсах и одежде. Попробую все что есть подготовить и натренировать в гиперсетке, посмотрю результаты. Если интересно, в течении месяца поделюсь результатами.
Дополню
Есть такие ощущения (может они вообще не верны) Лора тупо использует маску глубины с фото что ей скормили и в момент генерации картинки рандомно подсовывает реальное фото с этой маской и именно по этому сложно получить различные вариации фонов, причесок и т.п, S.D пытается по промту нарисовать красиво но по маске глубины особо не разгуляешься и по этому часто получается разрушенная кожа лица.
А вот гиперсеть есть ощущение пытается создать именно 3D модель лица, и так как она не скована никакой маской получаются более реалистичные и вариативные изображения.
У меня есть фотосет коллеги, в студии снимали. Там более 100 портретных снимков в разных ракурсах и одежде. Попробую все что есть подготовить и натренировать в гиперсетке, посмотрю результаты. Если интересно, в течении месяца поделюсь результатами.

Цитата: eLqwatRo от 09.03.2023, 02:39Здравствуйте. Не запускается SD portable. Сделал все по инструкции. Несколько раз переустанавливал, но все равно выдает одну и ту же ошибку. Подскажите пожалуйста куда копать.
[spoiler title=""]From https://github.com/AUTOMATIC1111/stable-diffusion-webui
* branch master -> FETCH_HEAD
Already up to date.
venv "venv\Scripts\Python.exe"
Python 3.10.6 (tags/v3.10.6:9c7b4bd, Aug 1 2022, 21:53:49) [MSC v.1932 64 bit (AMD64)]
Commit hash: 0cc0ee1bcb4c24a8c9715f66cede06601bfc00c8
Installing requirements for Web UI
Launching Web UI with arguments: --xformers --autolaunch
Checkpoint deliberate_v2.ckpt [44bf0551] not found; loading fallback deliberate_v2.ckpt [b4391b7978]
Loading weights [b4391b7978] from F:\stable-diffusion-portable-main\models\Stable-diffusion\deliberate_v2.ckpt
Creating model from config: F:\stable-diffusion-portable-main\configs\v1-inference.yaml
LatentDiffusion: Running in eps-prediction mode
DiffusionWrapper has 859.52 M params.
Failed to create model quickly; will retry using slow method.
LatentDiffusion: Running in eps-prediction mode
DiffusionWrapper has 859.52 M params.
loading stable diffusion model: OSError
Traceback (most recent call last):
File "F:\stable-diffusion-portable-main\webui.py", line 111, in initialize
modules.sd_models.load_model()
File "F:\stable-diffusion-portable-main\modules\sd_models.py", line 406, in load_model
sd_model = instantiate_from_config(sd_config.model)
File "F:\stable-diffusion-portable-main\repositories\stable-diffusion-stability-ai\ldm\util.py", line 79, in instantiate_from_config
return get_obj_from_str(config["target"])(**config.get("params", dict()))
File "F:\stable-diffusion-portable-main\repositories\stable-diffusion-stability-ai\ldm\models\diffusion\ddpm.py", line 563, in __init__
self.instantiate_cond_stage(cond_stage_config)
File "F:\stable-diffusion-portable-main\repositories\stable-diffusion-stability-ai\ldm\models\diffusion\ddpm.py", line 630, in instantiate_cond_stage
model = instantiate_from_config(config)
File "F:\stable-diffusion-portable-main\repositories\stable-diffusion-stability-ai\ldm\util.py", line 79, in instantiate_from_config
return get_obj_from_str(config["target"])(**config.get("params", dict()))
File "F:\stable-diffusion-portable-main\repositories\stable-diffusion-stability-ai\ldm\modules\encoders\modules.py", line 99, in __init__
self.tokenizer = CLIPTokenizer.from_pretrained(version)
File "F:\stable-diffusion-portable-main\venv\lib\site-packages\transformers\tokenization_utils_base.py", line 1801, in from_pretrained
return cls._from_pretrained(
File "F:\stable-diffusion-portable-main\venv\lib\site-packages\transformers\tokenization_utils_base.py", line 1849, in _from_pretrained
with open(tokenizer_config_file, encoding="utf-8") as tokenizer_config_handle:
OSError: [Errno 22] Invalid argument: 'tmp/.cache\\huggingface\\hub\\models--openai--clip-vit-large-patch14\\snapshots\\8d052a0f05efbaefbc9e8786ba291cfdf93e5bff\\tokenizer_config.json'Stable diffusion model failed to load, exiting[/spoiler]
Здравствуйте. Не запускается SD portable. Сделал все по инструкции. Несколько раз переустанавливал, но все равно выдает одну и ту же ошибку. Подскажите пожалуйста куда копать.
* branch master -> FETCH_HEAD
Already up to date.
venv "venv\Scripts\Python.exe"
Python 3.10.6 (tags/v3.10.6:9c7b4bd, Aug 1 2022, 21:53:49) [MSC v.1932 64 bit (AMD64)]
Commit hash: 0cc0ee1bcb4c24a8c9715f66cede06601bfc00c8
Installing requirements for Web UI
Launching Web UI with arguments: --xformers --autolaunch
Checkpoint deliberate_v2.ckpt [44bf0551] not found; loading fallback deliberate_v2.ckpt [b4391b7978]
Loading weights [b4391b7978] from F:\stable-diffusion-portable-main\models\Stable-diffusion\deliberate_v2.ckpt
Creating model from config: F:\stable-diffusion-portable-main\configs\v1-inference.yaml
LatentDiffusion: Running in eps-prediction mode
DiffusionWrapper has 859.52 M params.
Failed to create model quickly; will retry using slow method.
LatentDiffusion: Running in eps-prediction mode
DiffusionWrapper has 859.52 M params.
loading stable diffusion model: OSError
Traceback (most recent call last):
File "F:\stable-diffusion-portable-main\webui.py", line 111, in initialize
modules.sd_models.load_model()
File "F:\stable-diffusion-portable-main\modules\sd_models.py", line 406, in load_model
sd_model = instantiate_from_config(sd_config.model)
File "F:\stable-diffusion-portable-main\repositories\stable-diffusion-stability-ai\ldm\util.py", line 79, in instantiate_from_config
return get_obj_from_str(config["target"])(**config.get("params", dict()))
File "F:\stable-diffusion-portable-main\repositories\stable-diffusion-stability-ai\ldm\models\diffusion\ddpm.py", line 563, in __init__
self.instantiate_cond_stage(cond_stage_config)
File "F:\stable-diffusion-portable-main\repositories\stable-diffusion-stability-ai\ldm\models\diffusion\ddpm.py", line 630, in instantiate_cond_stage
model = instantiate_from_config(config)
File "F:\stable-diffusion-portable-main\repositories\stable-diffusion-stability-ai\ldm\util.py", line 79, in instantiate_from_config
return get_obj_from_str(config["target"])(**config.get("params", dict()))
File "F:\stable-diffusion-portable-main\repositories\stable-diffusion-stability-ai\ldm\modules\encoders\modules.py", line 99, in __init__
self.tokenizer = CLIPTokenizer.from_pretrained(version)
File "F:\stable-diffusion-portable-main\venv\lib\site-packages\transformers\tokenization_utils_base.py", line 1801, in from_pretrained
return cls._from_pretrained(
File "F:\stable-diffusion-portable-main\venv\lib\site-packages\transformers\tokenization_utils_base.py", line 1849, in _from_pretrained
with open(tokenizer_config_file, encoding="utf-8") as tokenizer_config_handle:
OSError: [Errno 22] Invalid argument: 'tmp/.cache\\huggingface\\hub\\models--openai--clip-vit-large-patch14\\snapshots\\8d052a0f05efbaefbc9e8786ba291cfdf93e5bff\\tokenizer_config.json'
Stable diffusion model failed to load, exiting

Цитата: Alexey от 09.03.2023, 07:31Всем доброго времени суток, появилось хорошее расширения для генерации качественного описания изображения. " clip-interrogator-ext ". Описывает точно, подробно и на порядок лучше других аналогов. Но столкнулся с такой проблемой, устал мучатся. Когда нажимаю кнопку генерации промта вот такая ошибка. Хелп ми плииз!) RTX 3060 12gb. 32gb RAM
[spoiler title=""] From https://github.com/AUTOMATIC1111/stable-diffusion-webui
* branch master -> FETCH_HEAD
Already up to date.
venv "venv\Scripts\Python.exe"
Python 3.10.6 (tags/v3.10.6:9c7b4bd, Aug 1 2022, 21:53:49) [MSC v.1932 64 bit (AMD64)]
Commit hash: 0cc0ee1bcb4c24a8c9715f66cede06601bfc00c8
Installing requirements for Web UILaunching Web UI with arguments: --xformers --autolaunch
Loading weights [9aba26abdf] from D:\StableDefussion\stable-diffusion-portable-main\models\Stable-diffusion\deliberate_v2.safetensors
Creating model from config: D:\StableDefussion\stable-diffusion-portable-main\configs\v1-inference.yaml
LatentDiffusion: Running in eps-prediction mode
DiffusionWrapper has 859.52 M params.
Applying xformers cross attention optimization.
Textual inversion embeddings loaded(0):
Model loaded in 3.4s (create model: 0.4s, apply weights to model: 0.7s, apply half(): 0.9s, move model to device: 0.6s, load textual inversion embeddings: 0.9s).
Running on local URL: http://127.0.0.1:7860To create a public link, set `share=True` in `launch()`.
Loading CLIP Interrogator 0.5.4...
detected < 12GB VRAM, using low VRAM mode
Loading BLIP model...
Error verifying pickled file from tmp/.cache\torch\hub\checkpoints\model_base_caption_capfilt_large.pth:
Traceback (most recent call last):
File "D:\StableDefussion\stable-diffusion-portable-main\modules\safe.py", line 81, in check_pt
with zipfile.ZipFile(filename) as z:
File "D:\StableDefussion\stable-diffusion-portable-main\python\lib\zipfile.py", line 1267, in __init__
self._RealGetContents()
File "D:\StableDefussion\stable-diffusion-portable-main\python\lib\zipfile.py", line 1334, in _RealGetContents
raise BadZipFile("File is not a zip file")
zipfile.BadZipFile: File is not a zip fileDuring handling of the above exception, another exception occurred:
Traceback (most recent call last):
File "D:\StableDefussion\stable-diffusion-portable-main\modules\safe.py", line 135, in load_with_extra
check_pt(filename, extra_handler)
File "D:\StableDefussion\stable-diffusion-portable-main\modules\safe.py", line 102, in check_pt
unpickler.load()
_pickle.UnpicklingError: persistent IDs in protocol 0 must be ASCII strings-----> !!!! The file is most likely corrupted !!!! <-----
You can skip this check with --disable-safe-unpickle commandline argument, but that is not going to help you.Traceback (most recent call last):
File "D:\StableDefussion\stable-diffusion-portable-main\venv\lib\site-packages\gradio\routes.py", line 337, in run_predict
output = await app.get_blocks().process_api(
File "D:\StableDefussion\stable-diffusion-portable-main\venv\lib\site-packages\gradio\blocks.py", line 1015, in process_api
result = await self.call_function(
File "D:\StableDefussion\stable-diffusion-portable-main\venv\lib\site-packages\gradio\blocks.py", line 833, in call_function
prediction = await anyio.to_thread.run_sync(
File "D:\StableDefussion\stable-diffusion-portable-main\venv\lib\site-packages\anyio\to_thread.py", line 31, in run_sync
return await get_asynclib().run_sync_in_worker_thread(
File "D:\StableDefussion\stable-diffusion-portable-main\venv\lib\site-packages\anyio\_backends\_asyncio.py", line 937, in run_sync_in_worker_thread
return await future
File "D:\StableDefussion\stable-diffusion-portable-main\venv\lib\site-packages\anyio\_backends\_asyncio.py", line 867, in run
result = context.run(func, *args)
File "D:\StableDefussion\stable-diffusion-portable-main\extensions\clip-interrogator-ext\scripts\clip_interrogator_ext.py", line 131, in image_to_prompt
load(clip_model_name)
File "D:\StableDefussion\stable-diffusion-portable-main\extensions\clip-interrogator-ext\scripts\clip_interrogator_ext.py", line 69, in load
ci = Interrogator(config)
File "D:\StableDefussion\stable-diffusion-portable-main\venv\lib\site-packages\clip_interrogator\clip_interrogator.py", line 77, in __init__
blip_model = blip_decoder(
File "D:\StableDefussion\stable-diffusion-portable-main\venv\lib\site-packages\blip\models\blip.py", line 175, in blip_decoder
model,msg = load_checkpoint(model,pretrained)
File "D:\StableDefussion\stable-diffusion-portable-main\venv\lib\site-packages\blip\models\blip.py", line 224, in load_checkpoint
state_dict = checkpoint['model']
TypeError: 'NoneType' object is not subscriptable [/spoiler]
Всем доброго времени суток, появилось хорошее расширения для генерации качественного описания изображения. " clip-interrogator-ext ". Описывает точно, подробно и на порядок лучше других аналогов. Но столкнулся с такой проблемой, устал мучатся. Когда нажимаю кнопку генерации промта вот такая ошибка. Хелп ми плииз!) RTX 3060 12gb. 32gb RAM
* branch master -> FETCH_HEAD
Already up to date.
venv "venv\Scripts\Python.exe"
Python 3.10.6 (tags/v3.10.6:9c7b4bd, Aug 1 2022, 21:53:49) [MSC v.1932 64 bit (AMD64)]
Commit hash: 0cc0ee1bcb4c24a8c9715f66cede06601bfc00c8
Installing requirements for Web UI
Launching Web UI with arguments: --xformers --autolaunch
Loading weights [9aba26abdf] from D:\StableDefussion\stable-diffusion-portable-main\models\Stable-diffusion\deliberate_v2.safetensors
Creating model from config: D:\StableDefussion\stable-diffusion-portable-main\configs\v1-inference.yaml
LatentDiffusion: Running in eps-prediction mode
DiffusionWrapper has 859.52 M params.
Applying xformers cross attention optimization.
Textual inversion embeddings loaded(0):
Model loaded in 3.4s (create model: 0.4s, apply weights to model: 0.7s, apply half(): 0.9s, move model to device: 0.6s, load textual inversion embeddings: 0.9s).
Running on local URL: http://127.0.0.1:7860
To create a public link, set `share=True` in `launch()`.
Loading CLIP Interrogator 0.5.4...
detected < 12GB VRAM, using low VRAM mode
Loading BLIP model...
Error verifying pickled file from tmp/.cache\torch\hub\checkpoints\model_base_caption_capfilt_large.pth:
Traceback (most recent call last):
File "D:\StableDefussion\stable-diffusion-portable-main\modules\safe.py", line 81, in check_pt
with zipfile.ZipFile(filename) as z:
File "D:\StableDefussion\stable-diffusion-portable-main\python\lib\zipfile.py", line 1267, in __init__
self._RealGetContents()
File "D:\StableDefussion\stable-diffusion-portable-main\python\lib\zipfile.py", line 1334, in _RealGetContents
raise BadZipFile("File is not a zip file")
zipfile.BadZipFile: File is not a zip file
During handling of the above exception, another exception occurred:
Traceback (most recent call last):
File "D:\StableDefussion\stable-diffusion-portable-main\modules\safe.py", line 135, in load_with_extra
check_pt(filename, extra_handler)
File "D:\StableDefussion\stable-diffusion-portable-main\modules\safe.py", line 102, in check_pt
unpickler.load()
_pickle.UnpicklingError: persistent IDs in protocol 0 must be ASCII strings
-----> !!!! The file is most likely corrupted !!!! <-----
You can skip this check with --disable-safe-unpickle commandline argument, but that is not going to help you.
Traceback (most recent call last):
File "D:\StableDefussion\stable-diffusion-portable-main\venv\lib\site-packages\gradio\routes.py", line 337, in run_predict
output = await app.get_blocks().process_api(
File "D:\StableDefussion\stable-diffusion-portable-main\venv\lib\site-packages\gradio\blocks.py", line 1015, in process_api
result = await self.call_function(
File "D:\StableDefussion\stable-diffusion-portable-main\venv\lib\site-packages\gradio\blocks.py", line 833, in call_function
prediction = await anyio.to_thread.run_sync(
File "D:\StableDefussion\stable-diffusion-portable-main\venv\lib\site-packages\anyio\to_thread.py", line 31, in run_sync
return await get_asynclib().run_sync_in_worker_thread(
File "D:\StableDefussion\stable-diffusion-portable-main\venv\lib\site-packages\anyio\_backends\_asyncio.py", line 937, in run_sync_in_worker_thread
return await future
File "D:\StableDefussion\stable-diffusion-portable-main\venv\lib\site-packages\anyio\_backends\_asyncio.py", line 867, in run
result = context.run(func, *args)
File "D:\StableDefussion\stable-diffusion-portable-main\extensions\clip-interrogator-ext\scripts\clip_interrogator_ext.py", line 131, in image_to_prompt
load(clip_model_name)
File "D:\StableDefussion\stable-diffusion-portable-main\extensions\clip-interrogator-ext\scripts\clip_interrogator_ext.py", line 69, in load
ci = Interrogator(config)
File "D:\StableDefussion\stable-diffusion-portable-main\venv\lib\site-packages\clip_interrogator\clip_interrogator.py", line 77, in __init__
blip_model = blip_decoder(
File "D:\StableDefussion\stable-diffusion-portable-main\venv\lib\site-packages\blip\models\blip.py", line 175, in blip_decoder
model,msg = load_checkpoint(model,pretrained)
File "D:\StableDefussion\stable-diffusion-portable-main\venv\lib\site-packages\blip\models\blip.py", line 224, in load_checkpoint
state_dict = checkpoint['model']
TypeError: 'NoneType' object is not subscriptable