

Stable Diffusion

Цитата: Venus от 14.12.2022, 13:51Подскажите, реально ли подсунуть в этот UI переводчик? Некоторые слова приходится вбивать в другой вкладке в deepl и, по сути, это отнимает много времени. Оптимизация - наше всё!
Я бы и сам поделился, но не умею кодить. Два часа убил на краши питона, в итоге весь мой прогресс заключается в том, что я узнал название модуля webbrowser.Как идеально бы было, если бы вот в этом пустом месте были волшебные два поля 😄 Ладно там deepl, хотя бы простенький гугл транслейтер с ru на en.
[spoiler title="++++++++++++++++++++++++++++++++"]
[/spoiler]
Если кому-то интересно покопаться, то вот всё что я знаю:
Файлик интерфейса: modules/ui.py
Кушает без ошибок команду "import webbrowser"
Перезагрузить UI: Вкладка Extensions > Apply and restart UI
Подскажите, реально ли подсунуть в этот UI переводчик? Некоторые слова приходится вбивать в другой вкладке в deepl и, по сути, это отнимает много времени. Оптимизация - наше всё!
Я бы и сам поделился, но не умею кодить. Два часа убил на краши питона, в итоге весь мой прогресс заключается в том, что я узнал название модуля webbrowser.
Как идеально бы было, если бы вот в этом пустом месте были волшебные два поля 😄 Ладно там deepl, хотя бы простенький гугл транслейтер с ru на en.

Если кому-то интересно покопаться, то вот всё что я знаю:
Файлик интерфейса: modules/ui.py
Кушает без ошибок команду "import webbrowser"
Перезагрузить UI: Вкладка Extensions > Apply and restart UI
Цитата: Venus от 14.12.2022, 13:59Покопавшись во вкладке Extensions, подозреваю, что всё это дело можно оформить как отдельно подгружаемое расширение.
Покопавшись во вкладке Extensions, подозреваю, что всё это дело можно оформить как отдельно подгружаемое расширение.

Цитата: Никита от 14.12.2022, 20:12Всем QQ.
А можно ли к портативке прикуртить ещё модуль Depth to Image?
Он делает на основе выбранной картинки маску глубины и после этого можно просто одним запросом в промпте заменить одну часть картиники или объект на другую. Например закинуть в область модуля картинку железного человека без шлема и написать запрос "Blondie girl in iron-man suite" и этот модуль сгенерирует ту же картинку что и рефернес, но с изменённым лицом.
Если можно поставить его, как дополнительный модуль, то как это делать?
Всем QQ.
А можно ли к портативке прикуртить ещё модуль Depth to Image?
Он делает на основе выбранной картинки маску глубины и после этого можно просто одним запросом в промпте заменить одну часть картиники или объект на другую. Например закинуть в область модуля картинку железного человека без шлема и написать запрос "Blondie girl in iron-man suite" и этот модуль сгенерирует ту же картинку что и рефернес, но с изменённым лицом.
Если можно поставить его, как дополнительный модуль, то как это делать?

Цитата: Сергей от 14.12.2022, 20:20Никита, привет 🖐
Это можно сделать с помощью Inpaint, указать, что Тебе нужно оставить, а что поменять и каким запросом.
Никита, привет 🖐
Это можно сделать с помощью Inpaint, указать, что Тебе нужно оставить, а что поменять и каким запросом.

Цитата: XpucT от 14.12.2022, 21:18Сегодня на официальном wiki от AUTOMATIC1111 узнал об интересном лайфхаке. Сейчас опишу понятным языком.
Если в prompt задать
cat and dog, то на выходе будет кот и собака. Количество и качество котов/собак зависит как от модели, так и от количества шагов и скейла. Так вот, если нам нужен именно котопёс, то уже пишем так:cat AND dog. Случаи, в которых AND пишется большими буквами, будут означать, что нам нужно слияние того, что идёт перед AND и после. Это можно использовать и для смешивания цветов. Не только для мутаций животных. Применение каждый себе найдёт 👍Например, если нужно смешать кота и дракона, то прибегаем ко скобкам для дракона, т.к. коты популярнее и они собой обычно затмевают любых драконов.
Сегодня на официальном wiki от AUTOMATIC1111 узнал об интересном лайфхаке. Сейчас опишу понятным языком.
Если в prompt задать Скопированоcat and dog, то на выходе будет кот и собака. Количество и качество котов/собак зависит как от модели, так и от количества шагов и скейла. Так вот, если нам нужен именно котопёс, то уже пишем так: Скопированоcat AND dog. Случаи, в которых AND пишется большими буквами, будут означать, что нам нужно слияние того, что идёт перед AND и после. Это можно использовать и для смешивания цветов. Не только для мутаций животных. Применение каждый себе найдёт 👍
Например, если нужно смешать кота и дракона, то прибегаем ко скобкам для дракона, т.к. коты популярнее и они собой обычно затмевают любых драконов.
Цитата: Никита от 14.12.2022, 23:03Цитата: Сергей от 14.12.2022, 20:20с помощью Inpaint
И да и нет... Вот такое и такое делается просто за счёт разных промтов. Всё-таки разное предназанчение у этого ИМХО.
Если кто-то сможет подогнать эту инструкцию для портативки Stable Diffusion то будет пушка.
Цитата: Сергей от 14.12.2022, 20:20с помощью Inpaint
И да и нет... Вот такое и такое делается просто за счёт разных промтов. Всё-таки разное предназанчение у этого ИМХО.
Если кто-то сможет подогнать эту инструкцию для портативки Stable Diffusion то будет пушка.
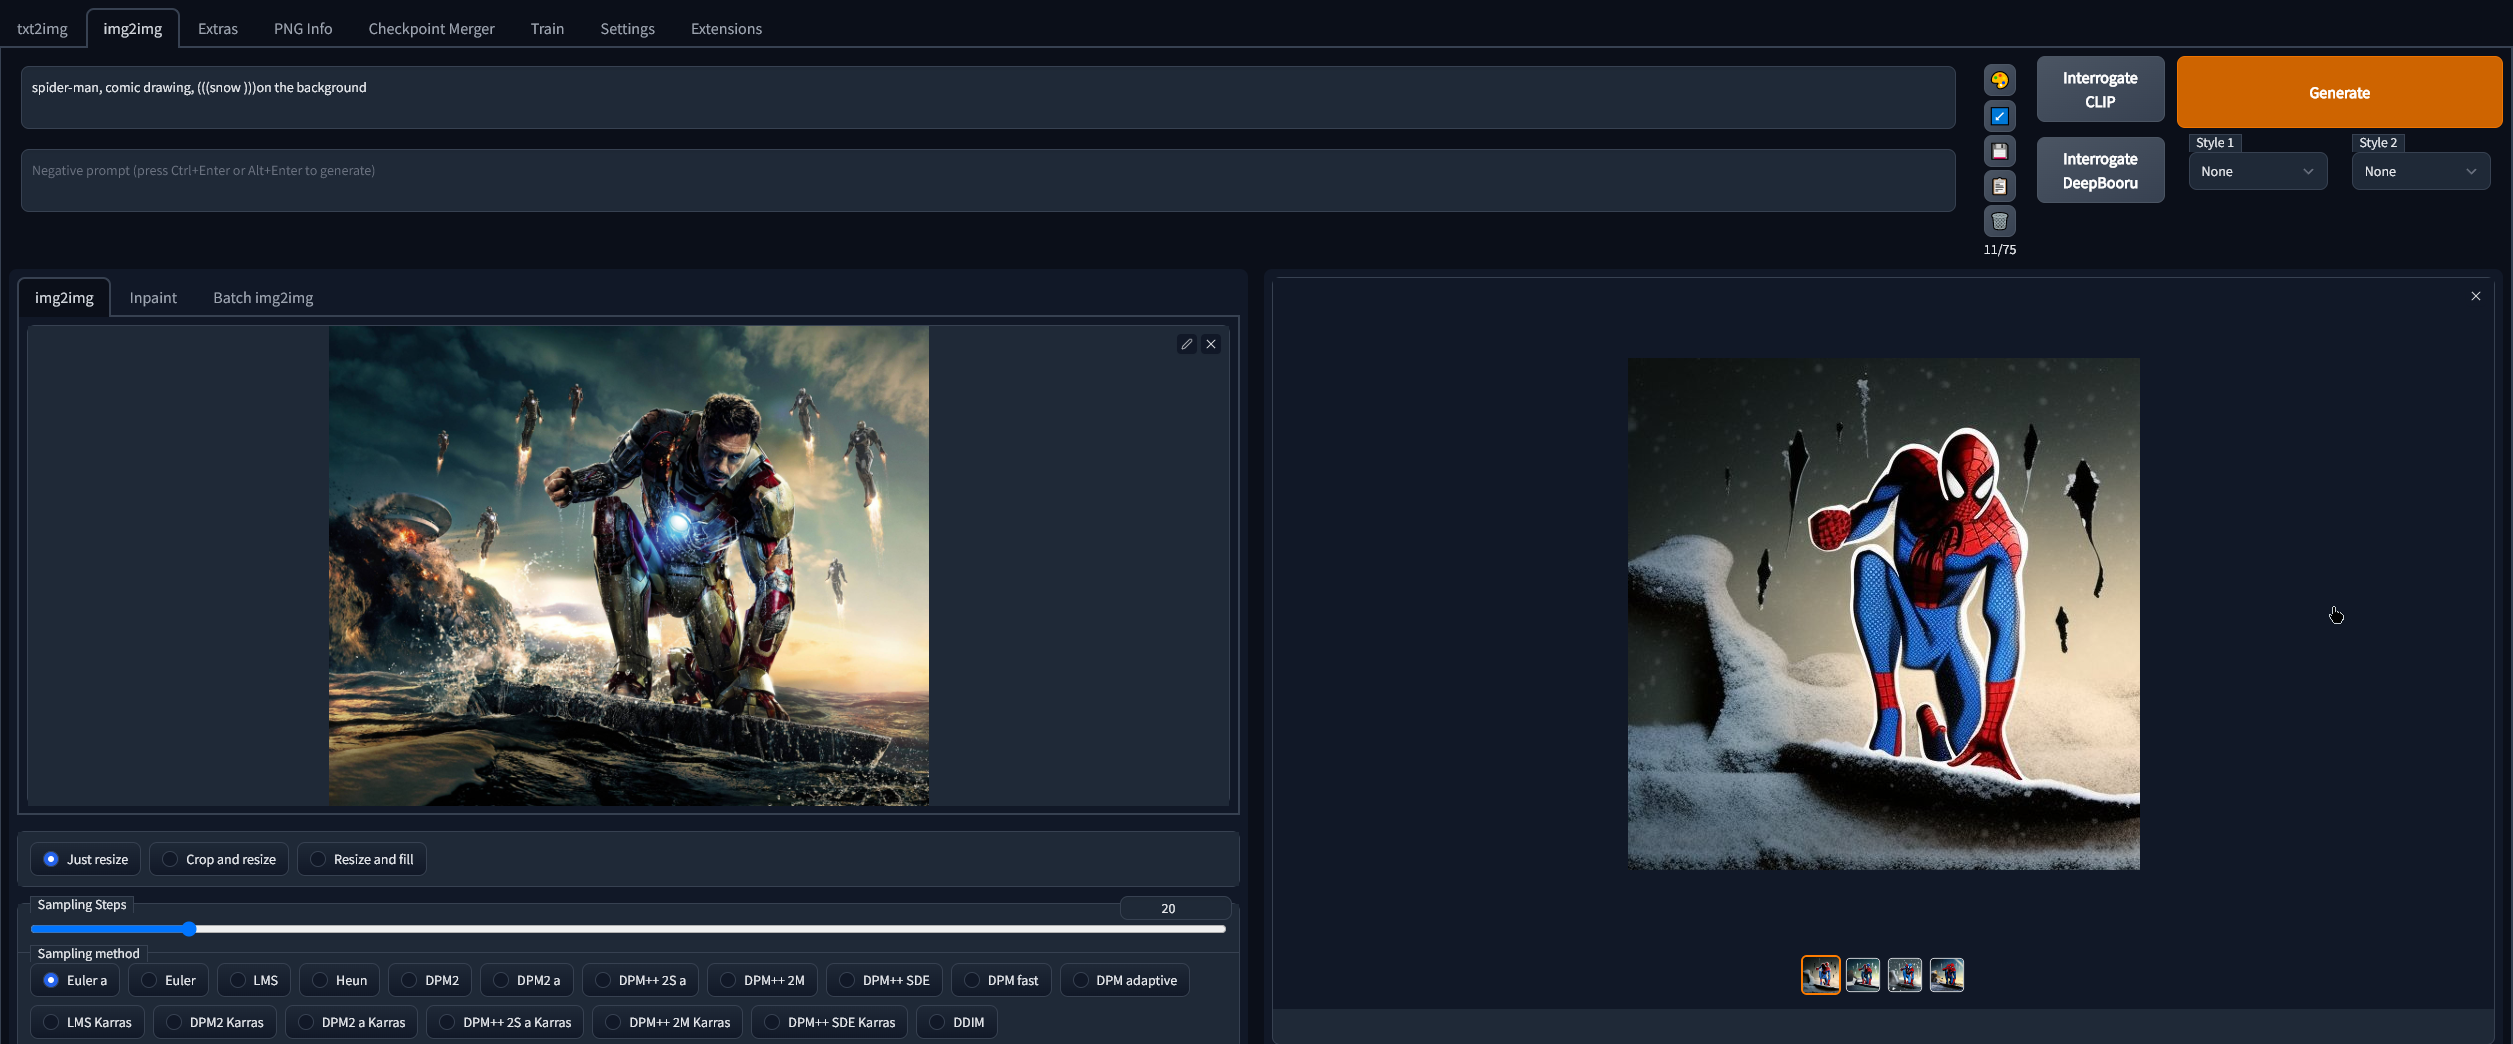
Цитата: Никита от 15.12.2022, 00:23Победил depth2img.
Ещё раз, суть в том, что он сначала генерирует маску глубины Вашей иходной картинки, чтобы понять, какой объект основной, какой второстепенный, третьестепенный и так далее.
А потом имея эти данные модель depth2img на основе Вашего промта рисует идентичную картинку, но уже с желаемыми параметрами.
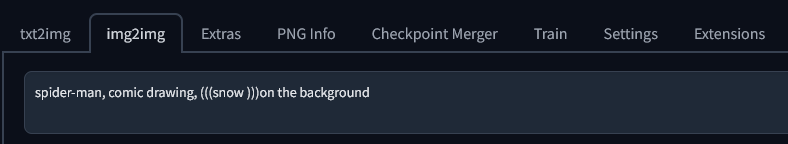
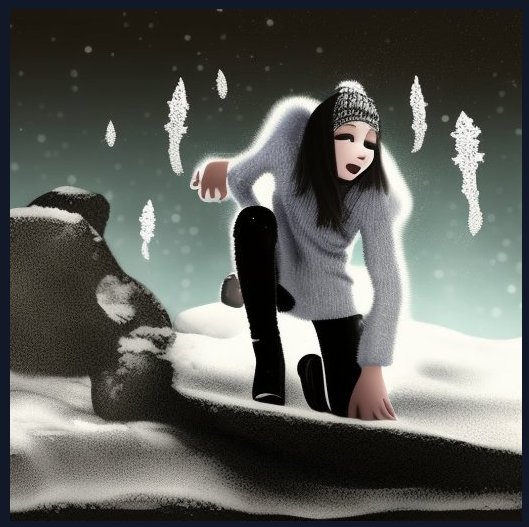
Сначала мой пример с очень простым промптом буквально из пары словосочетаний
[spoiler title="spider-man, comic drawing, (((snow )))on the background"][/spoiler]
Как установить без следов и мусора, полностью портативно.
[spoiler title="Поехали"]1. Качаем файл модели ИИ отсюда (прямая ссылка 5.31Gb)
2. Качаем файл конфига для этой модели отсюда (прямая ссылка 2Kb)
3. Кладём оба файла по пути "Папка Stable-Difussion\models\Stable-diffusion\"
4. Запускаем сам S-D через батник "webui-user.bat" как обычно.
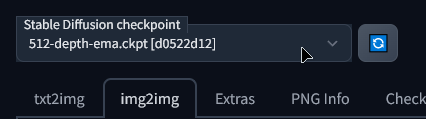
5. И вверху выбираем только что скачанную модель (скрин)
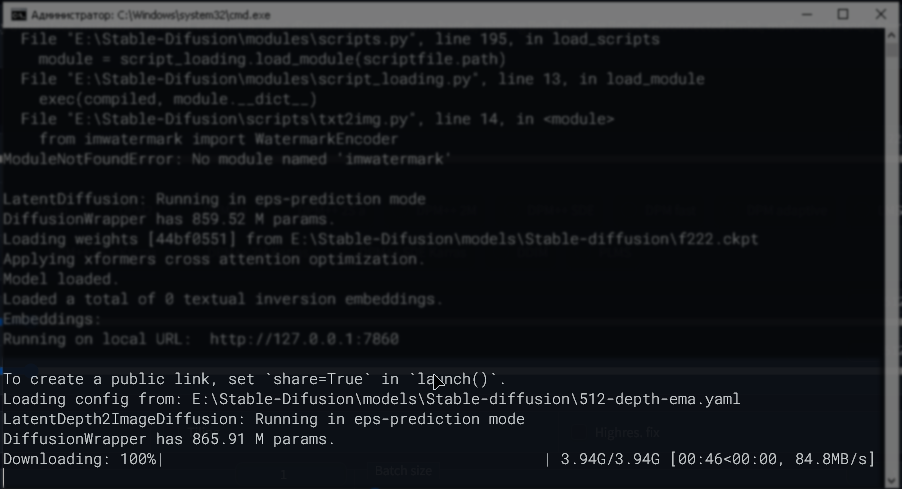
5.1. Покажется, что страница зависла, не трогаем, открываем нашу командную строку, в которой будет виден процесс установки этой модели, будет качать ещё 4Gb (скрин)
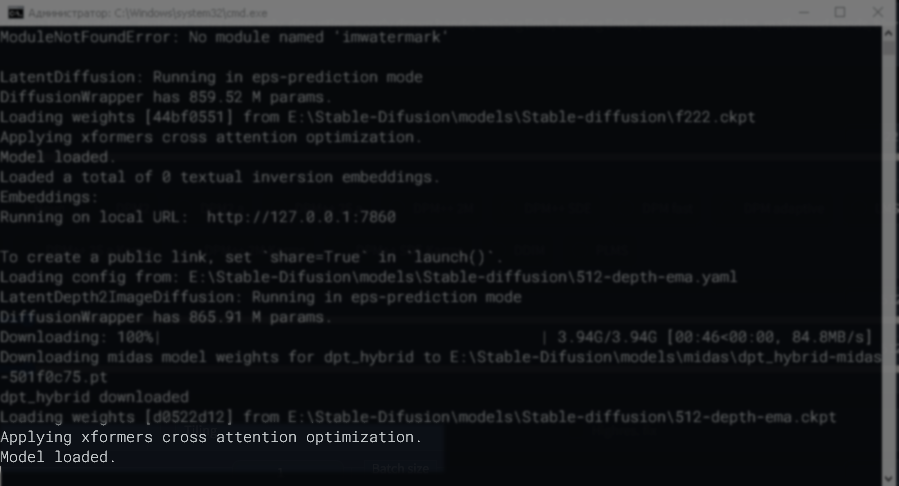
5.2. Ждём ещё минутку, пока не появится строка "Model loaded" (скрин)
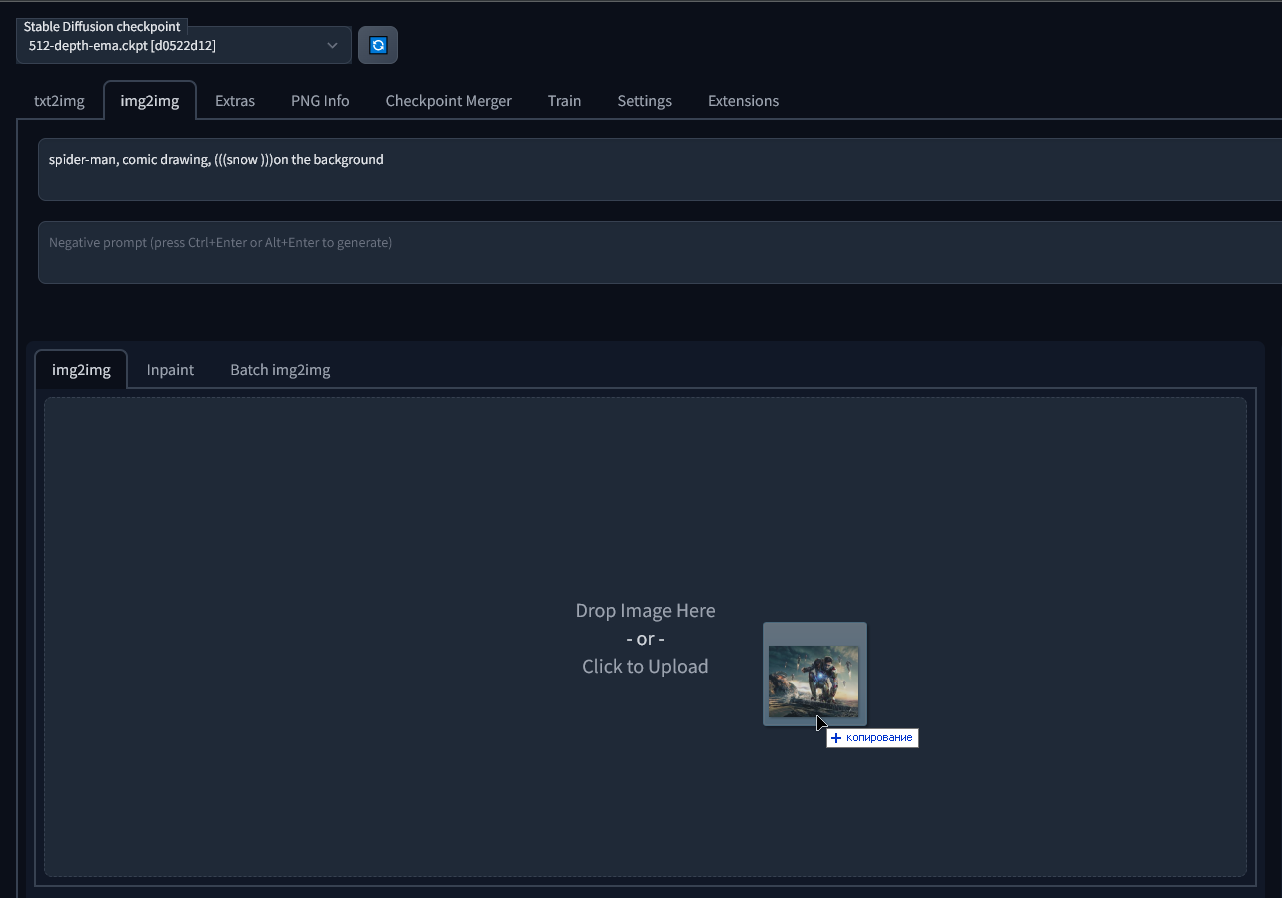
6. Идём в наш Stable-Diffusion во вкладку "img2img" и загружаем исходную картинку на основе, которой хотим работать (скрин)
7. Пишем наш промпт, что хотим получить и генерируем картинку (скрин)
8. Смотрим на результат (скрин, скрин)
[/spoiler]
Победил depth2img.
Ещё раз, суть в том, что он сначала генерирует маску глубины Вашей иходной картинки, чтобы понять, какой объект основной, какой второстепенный, третьестепенный и так далее.
А потом имея эти данные модель depth2img на основе Вашего промта рисует идентичную картинку, но уже с желаемыми параметрами.
Сначала мой пример с очень простым промптом буквально из пары словосочетаний
Как установить без следов и мусора, полностью портативно.
2. Качаем файл конфига для этой модели отсюда (прямая ссылка 2Kb)
3. Кладём оба файла по пути "Папка Stable-Difussion\models\Stable-diffusion\"
4. Запускаем сам S-D через батник "webui-user.bat" как обычно.
5. И вверху выбираем только что скачанную модель (скрин)
5.1. Покажется, что страница зависла, не трогаем, открываем нашу командную строку, в которой будет виден процесс установки этой модели, будет качать ещё 4Gb (скрин)
5.2. Ждём ещё минутку, пока не появится строка "Model loaded" (скрин)
6. Идём в наш Stable-Diffusion во вкладку "img2img" и загружаем исходную картинку на основе, которой хотим работать (скрин)
7. Пишем наш промпт, что хотим получить и генерируем картинку (скрин)
8. Смотрим на результат (скрин, скрин)
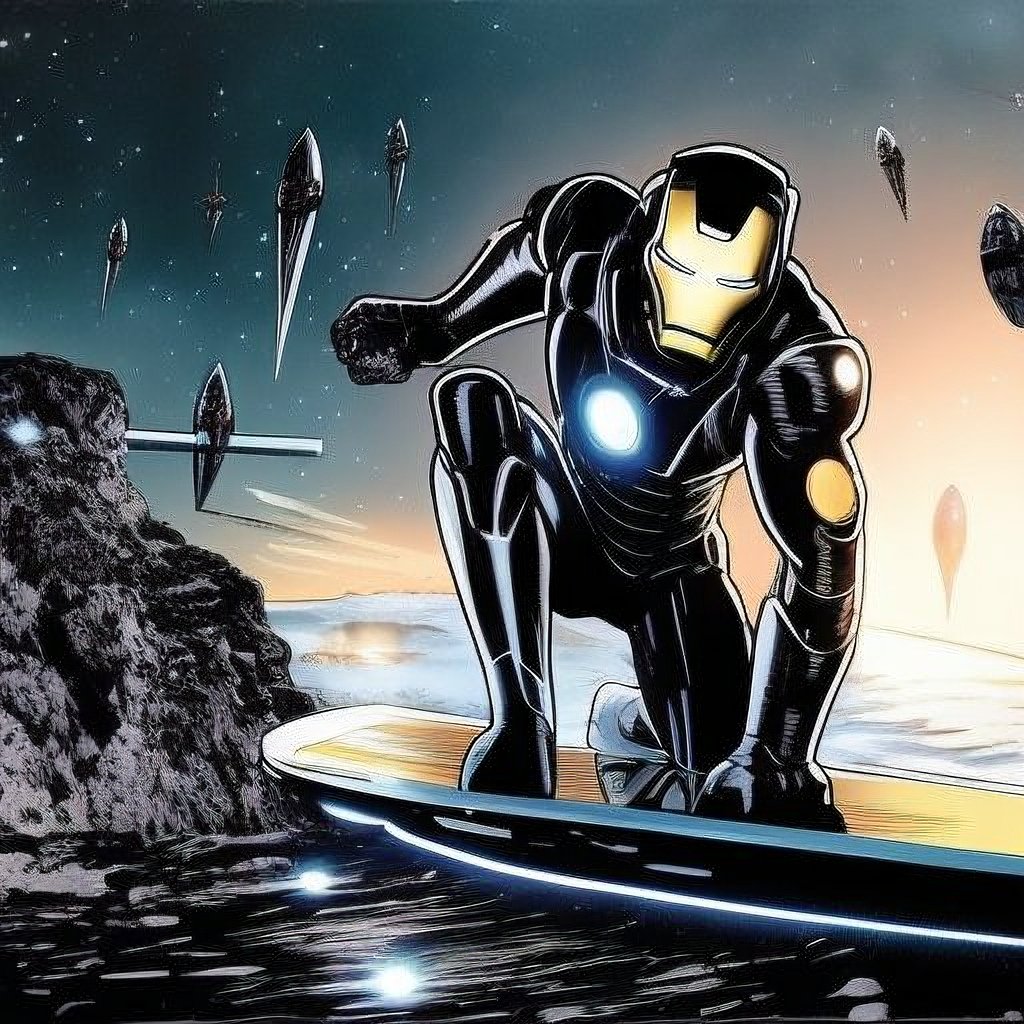
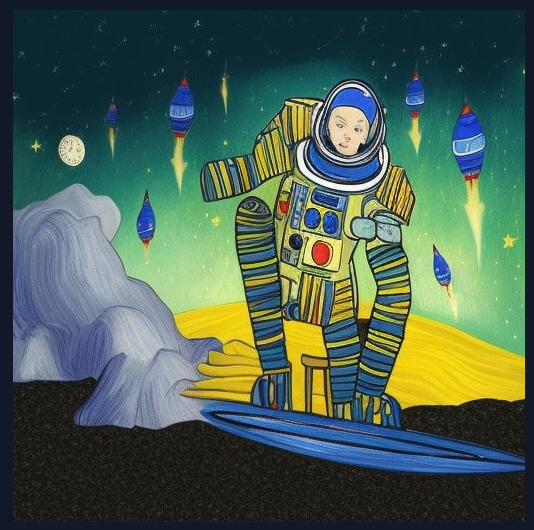
Цитата: Никита от 15.12.2022, 01:03Ещё пример на основе той же исходной картинки
[spoiler title="iron-man, black suite, comic drawing, on the glass surfboard, space on the background, starlights"]
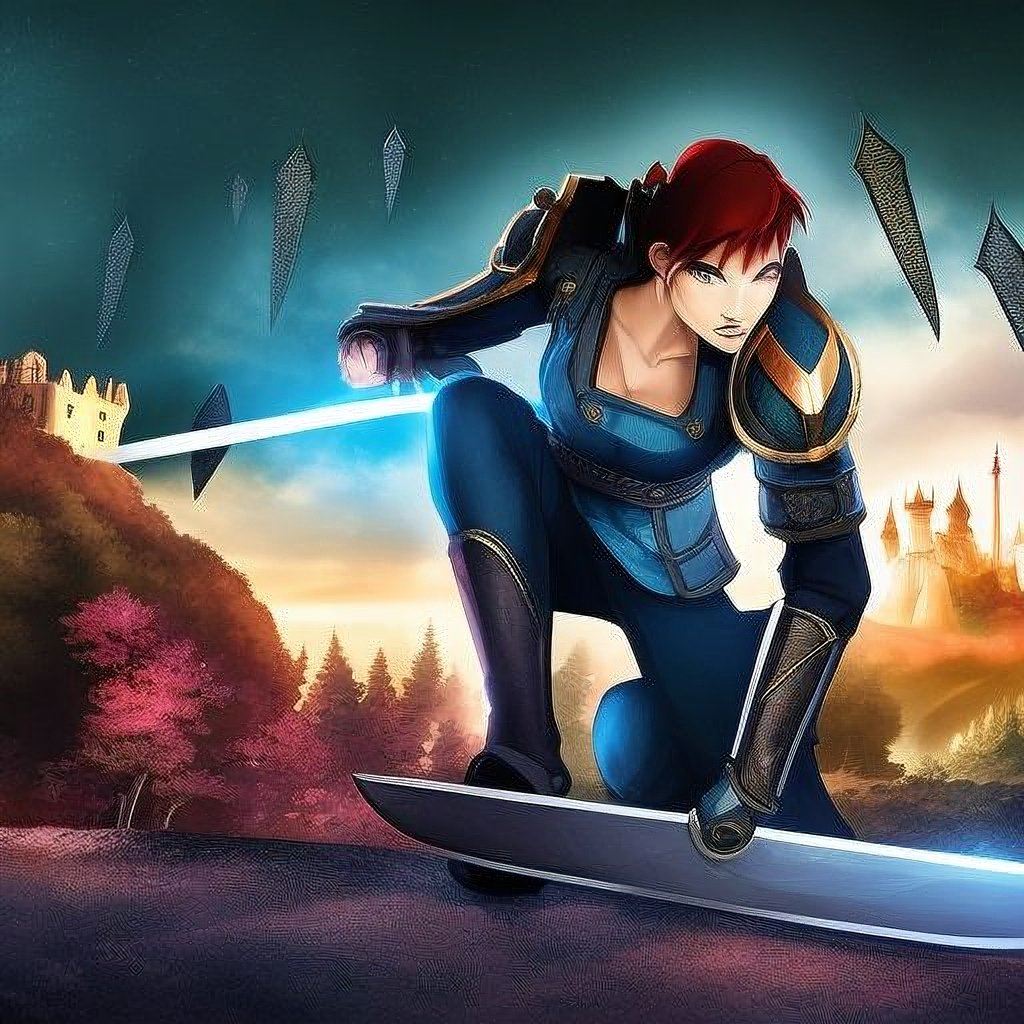
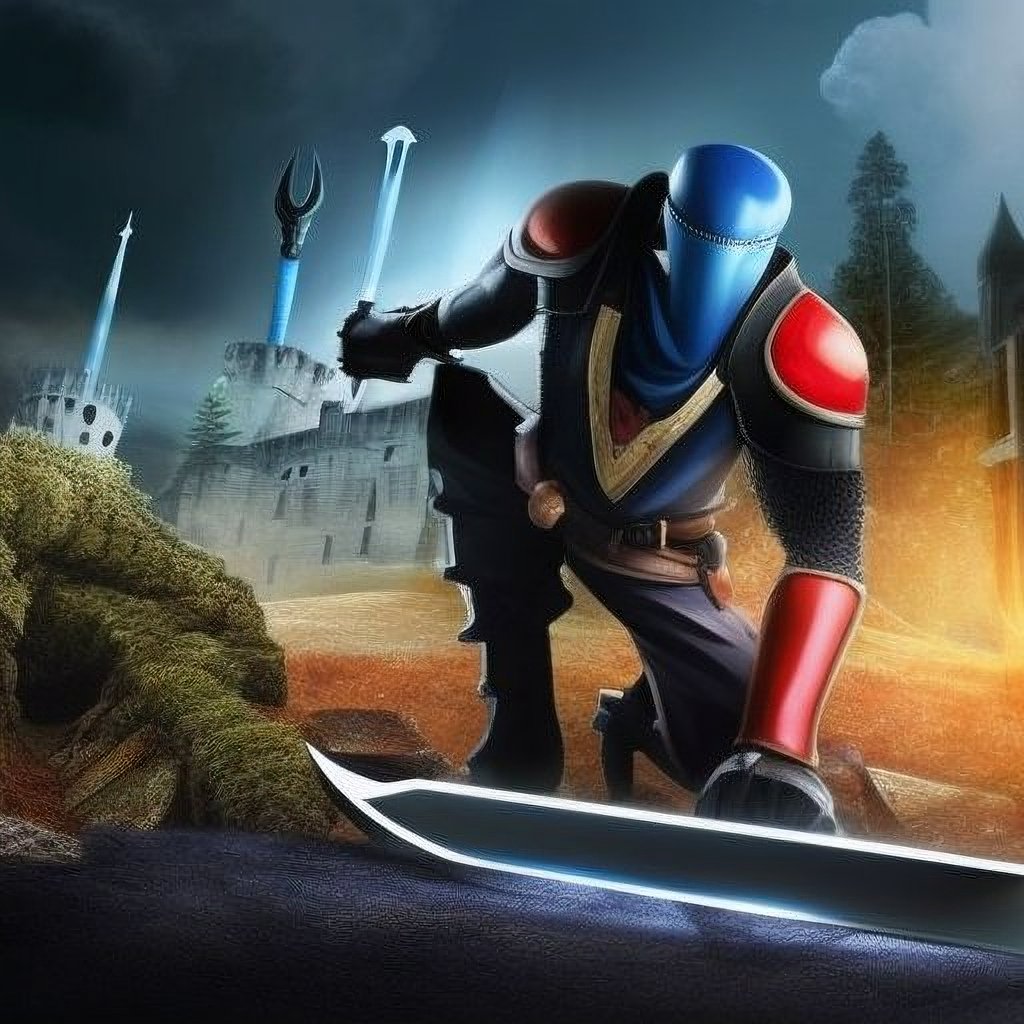
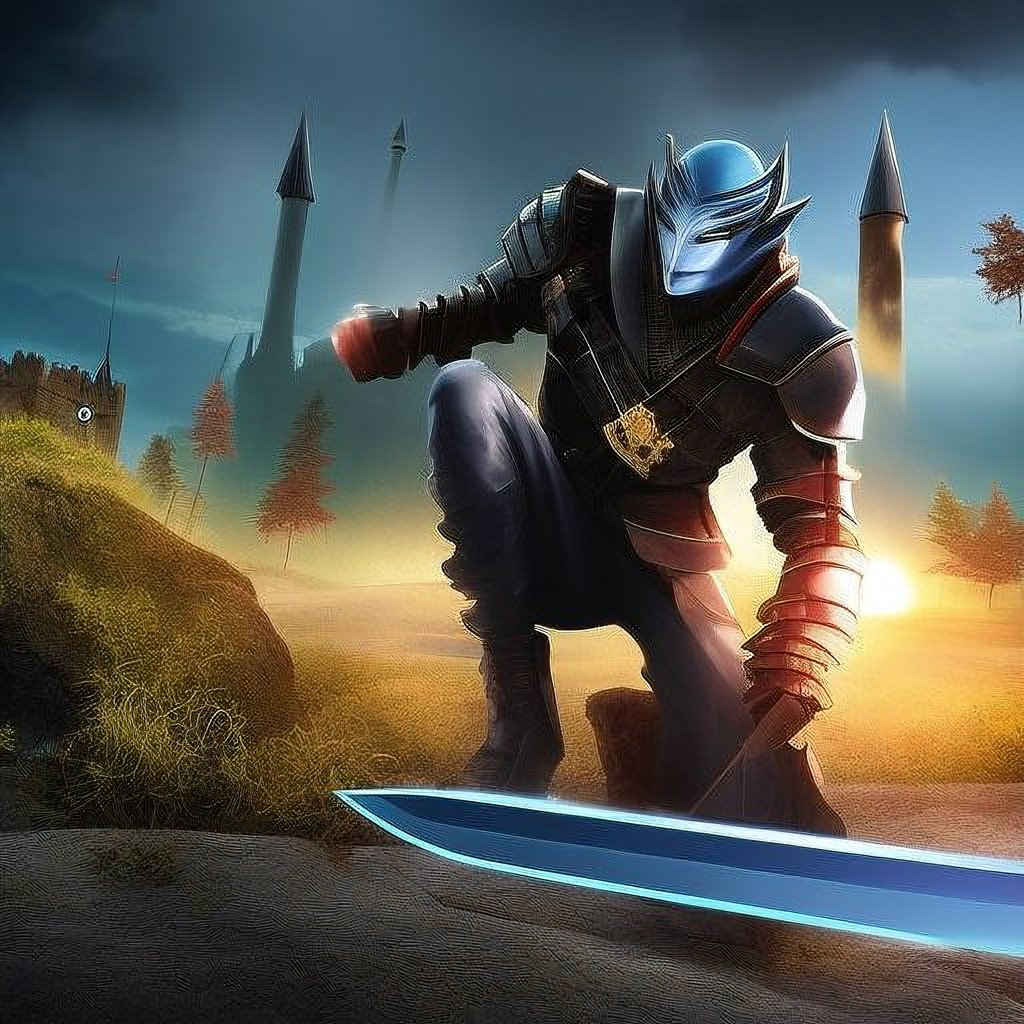
[spoiler title="И разные рыцари"]
Ещё пример на основе той же исходной картинки


Цитата: Mikhail от 15.12.2022, 03:47Спасибо за гайд, я бы еще посоветовал поставить галочку тут, чтоб он дорисовывал еще, а то у меня с людьми, мутанты получаются 3-х рукие какие-то, даже с негативным промптом.
Спасибо за гайд, я бы еще посоветовал поставить галочку тут, чтоб он дорисовывал еще, а то у меня с людьми, мутанты получаются 3-х рукие какие-то, даже с негативным промптом.

Цитата: Vilen от 15.12.2022, 11:51Кто что узнал по поводу ремикс мода? Когда две фотки соединяешь и он что-то среднее делает, вот midjourney [spoiler title=""]
[spoiler title=""]
Кто что узнал по поводу ремикс мода? Когда две фотки соединяешь и он что-то среднее делает, вот midjourney


Цитата: menny225 от 15.12.2022, 13:15День добрый господа! Хотел бы поинтересоваться по поводу переобучения готового hypernetwork'а. Как я понял, из видео Хачатура, достаточно выбрать уже обученный hypernetwork и прогнать другим датасетом, но почему-то у меня не получается это сделать по причине того, что появляется надпись об успешной тренировке, которая происходила вчера на первом датасете.
P.S Вот видео, где более в понятном виде отображается моя проблема.

День добрый господа! Хотел бы поинтересоваться по поводу переобучения готового hypernetwork'а. Как я понял, из видео Хачатура, достаточно выбрать уже обученный hypernetwork и прогнать другим датасетом, но почему-то у меня не получается это сделать по причине того, что появляется надпись об успешной тренировке, которая происходила вчера на первом датасете.
P.S Вот видео, где более в понятном виде отображается моя проблема.

Цитата: Денис от 15.12.2022, 15:34Добрый день, возникла проблема. На стадии заливки фотографий для обучения, во вкладке Preprocess images если ставлю галочку на (Use BLIP for caption) и указываю название папки выдает ошибку IndexError: list index out of range. Если (Use BLIP for caption) не стоит, то прогружается, но в дальнейшем проходит 0 шагов и результатов при генерации нет, то есть выдаются рандомные изображения.
Добрый день, возникла проблема. На стадии заливки фотографий для обучения, во вкладке Preprocess images если ставлю галочку на (Use BLIP for caption) и указываю название папки выдает ошибку IndexError: list index out of range. Если (Use BLIP for caption) не стоит, то прогружается, но в дальнейшем проходит 0 шагов и результатов при генерации нет, то есть выдаются рандомные изображения.

Цитата: Глеб от 15.12.2022, 16:10Цитата: menny225 от 15.12.2022, 13:15День добрый господа! Хотел бы поинтересоваться по поводу переобучения готового hypernetwork'а. Как я понял, из видео Хачатура, достаточно выбрать уже обученный hypernetwork и прогнать другим датасетом, но почему-то у меня не получается это сделать по причине того, что появляется надпись об успешной тренировке, которая происходила вчера на первом датасете.
P.S Вот видео, где более в понятном виде отображается моя проблема.
Добрый день. Вчера вечером столкнулся с этой бедой. Можно поставить большее значение Max step, но результат обучения будет печальный, либо создать новый hypernetwork. Проблемы пока не вылезали.
Цитата: menny225 от 15.12.2022, 13:15День добрый господа! Хотел бы поинтересоваться по поводу переобучения готового hypernetwork'а. Как я понял, из видео Хачатура, достаточно выбрать уже обученный hypernetwork и прогнать другим датасетом, но почему-то у меня не получается это сделать по причине того, что появляется надпись об успешной тренировке, которая происходила вчера на первом датасете.
P.S Вот видео, где более в понятном виде отображается моя проблема.
Добрый день. Вчера вечером столкнулся с этой бедой. Можно поставить большее значение Max step, но результат обучения будет печальный, либо создать новый hypernetwork. Проблемы пока не вылезали.
Цитата: Vilen от 15.12.2022, 21:45Цитата: Никита от 15.12.2022, 00:23Победил depth2img.
Ещё раз, суть в том, что он сначала генерирует маску глубины Вашей иходной картинки, чтобы понять, какой объект основной, какой второстепенный, третьестепенный и так далее.Отличная модель, но можно как то реализовать без цензуры как у f222? Потому что на многие запросы ничего не меняет, хочу задний фон из костей или крови и тд, там просто другое что-то делает, или я не так запрос пишу или там цензура жесткая? пробовал с f222, там сразу любой запрос работает, но криво меняет картинку, в depth-ema с этим все в разы лучше, но цензура мешает, возможно как то через слияние двух моделей попробовать?
Цитата: Никита от 15.12.2022, 00:23Победил depth2img.
Ещё раз, суть в том, что он сначала генерирует маску глубины Вашей иходной картинки, чтобы понять, какой объект основной, какой второстепенный, третьестепенный и так далее.
Отличная модель, но можно как то реализовать без цензуры как у f222? Потому что на многие запросы ничего не меняет, хочу задний фон из костей или крови и тд, там просто другое что-то делает, или я не так запрос пишу или там цензура жесткая? пробовал с f222, там сразу любой запрос работает, но криво меняет картинку, в depth-ema с этим все в разы лучше, но цензура мешает, возможно как то через слияние двух моделей попробовать?