

Stable Diffusion

Цитата: Сергей от 07.03.2023, 15:57Dmitry Tavlinski, приветствую 🖐
Тёмная тема включается с помощью аргумента--theme dark
Его нужно дописать в батник webui-user.bat
Dmitry Tavlinski, приветствую 🖐
Тёмная тема включается с помощью аргумента Скопировано--theme dark
Его нужно дописать в батник webui-user.bat

Цитата: Roma от 07.03.2023, 16:34Цитата: Dmitry Tavlinski от 07.03.2023, 15:54Дратути! Не подскажете как темную тему в SD включить? ...иии у ХрисТа в в видосе про портабл (https://www.youtube.com/watch?v=jepK6ufemMw&t=962s) чето всё как то по другому, нежели у того что в итоге с гитхаба скачалось)) - может подшаманить там чегонибудь 😉 заранее благодуха от уха до уха!
Тёмную тему в Cent можно включить, а если все так как у Христа нужно, скачай его конфиги с Бусти...)
Цитата: Dmitry Tavlinski от 07.03.2023, 15:54Дратути! Не подскажете как темную тему в SD включить? ...иии у ХрисТа в в видосе про портабл (https://www.youtube.com/watch?v=jepK6ufemMw&t=962s) чето всё как то по другому, нежели у того что в итоге с гитхаба скачалось)) - может подшаманить там чегонибудь 😉 заранее благодуха от уха до уха!
Тёмную тему в Cent можно включить, а если все так как у Христа нужно, скачай его конфиги с Бусти...)

Цитата: Dmitry Tavlinski от 07.03.2023, 16:39Спасибо!!!
Спасибо!!!

Цитата: see3 от 07.03.2023, 17:05Сергей,
из японского описания,
[spoiler title=""]
There are the following methods (each name is not a general one, but a definition unique to this repository). Regularized images will be discussed later.
DreamBooth, class+identifier method (regularized portrait can be used)
Learn to associate the learning object with a specific word (identifier). No need to provide captions. For example, if you use it to learn a specific character, you don't need to prepare captions, so it's easy, but all elements of the learning data such as hairstyles, clothes, and backgrounds are learned by being linked to identifiers. There may be situations where you can't change clothes at the prompt.
DreamBooth, captioning method (canonicalized images can be used)
Prepare and study a text file in which captions are recorded for each image. For example, when learning a specific character, by describing the details of the image in the caption (character A in white clothes, character A in red clothes, etc.), the character and other elements are separated, making it more precise You can expect the model to learn only the character at the time.[/spoiler]
Как раз ваш случай. При обучении без аннотации может получиться так, что причёска, одежда и т.д. будут привязаны к обьекту и их будет не поменять промптом.
Для этого нужен DreamBooth с аннотацией. Как я понимаю, указываемые теги не то что отделяются от обьекта, скорее модель учится использовать указанные теги одновременно с обьектом отдельно от него самого (укажете red dress - будет знать что красное платье на обьекте выглядит именно так. Ни разу не укажете цветы - не будет знать, как обьект обращается с цветами, только как это у его класса, из базовой модели).
Изображения класса надо использовать, улучшают выделение конкретного обьекта из общей массы (узнаваемость).
Я обычно использую заранее сгенерированные картинки, для класса woman - по промпту photo of a woman / photo of caucasian woman (штук 400-500 достаточно) - могу их выложить.
Для DreamBooth число шагов лучше укладывать в 1600-2000, т.е. число повторов указать (1600 - 2000)*batch_size/(2*samples) (*2 - от изображений класса). От этого числа зависит, как семплы поделятся по корзинам, при их использовании (и от batch_size тоже), поэтому качество трейна будет рандомно скакать - подобрать его на свой размер датасета. (Для класса указать повтор = 1, в названии папки 1_class или через basic caption сделать всем одинаковую аннотацию).
Но вот при использовании корзин и без ограничения их размера - начинает трейнить на 768*1024, типа того, и использование памяти улетает далеко за 12гб,
тут остаются только видеокарты 3090/4090 ...
Сергей,
из японского описания,
There are the following methods (each name is not a general one, but a definition unique to this repository). Regularized images will be discussed later.
-
DreamBooth, class+identifier method (regularized portrait can be used)
Learn to associate the learning object with a specific word (identifier). No need to provide captions. For example, if you use it to learn a specific character, you don't need to prepare captions, so it's easy, but all elements of the learning data such as hairstyles, clothes, and backgrounds are learned by being linked to identifiers. There may be situations where you can't change clothes at the prompt.
-
DreamBooth, captioning method (canonicalized images can be used)
Prepare and study a text file in which captions are recorded for each image. For example, when learning a specific character, by describing the details of the image in the caption (character A in white clothes, character A in red clothes, etc.), the character and other elements are separated, making it more precise You can expect the model to learn only the character at the time.
Как раз ваш случай. При обучении без аннотации может получиться так, что причёска, одежда и т.д. будут привязаны к обьекту и их будет не поменять промптом.
Для этого нужен DreamBooth с аннотацией. Как я понимаю, указываемые теги не то что отделяются от обьекта, скорее модель учится использовать указанные теги одновременно с обьектом отдельно от него самого (укажете red dress - будет знать что красное платье на обьекте выглядит именно так. Ни разу не укажете цветы - не будет знать, как обьект обращается с цветами, только как это у его класса, из базовой модели).
Изображения класса надо использовать, улучшают выделение конкретного обьекта из общей массы (узнаваемость).
Я обычно использую заранее сгенерированные картинки, для класса woman - по промпту photo of a woman / photo of caucasian woman (штук 400-500 достаточно) - могу их выложить.
Для DreamBooth число шагов лучше укладывать в 1600-2000, т.е. число повторов указать (1600 - 2000)*batch_size/(2*samples) (*2 - от изображений класса). От этого числа зависит, как семплы поделятся по корзинам, при их использовании (и от batch_size тоже), поэтому качество трейна будет рандомно скакать - подобрать его на свой размер датасета. (Для класса указать повтор = 1, в названии папки 1_class или через basic caption сделать всем одинаковую аннотацию).
Но вот при использовании корзин и без ограничения их размера - начинает трейнить на 768*1024, типа того, и использование памяти улетает далеко за 12гб,
тут остаются только видеокарты 3090/4090 ...

Цитата: Сергей от 07.03.2023, 18:06see3, О_О, я дико извиняюсь, но я сейчас наверно буду задавать очень глупые вопросы... DreamBooth - это другой метод тренировки, отличный от гиперсети и лоры? (я просто делал только гиперсеть и лору пока). Это то что в kohya_ss на первой закладке? А что на выходе получается? Полновесная модель? Или я опять чего то не понимаю?
see3, О_О, я дико извиняюсь, но я сейчас наверно буду задавать очень глупые вопросы... DreamBooth - это другой метод тренировки, отличный от гиперсети и лоры? (я просто делал только гиперсеть и лору пока). Это то что в kohya_ss на первой закладке? А что на выходе получается? Полновесная модель? Или я опять чего то не понимаю?
Цитата: see3 от 07.03.2023, 18:15Сергей, да, на выходе полная модель 2гб.
Посмотрите всё-таки или техн. видео koiboi или старые базовые видео Aitrepreneur по нему, если не видели.
DreamBooth обучение у автоматика лучше не использовать и не ставить, по программным требованиям получается совмещение несовместимого, всё ломается.
Лучше да, через kohya_ss gui(но вы понимаете, да, 80% успеха вы достигли, остальные 15% потребуют 80% усилий).
Сергей, да, на выходе полная модель 2гб.
Посмотрите всё-таки или техн. видео koiboi или старые базовые видео Aitrepreneur по нему, если не видели.
DreamBooth обучение у автоматика лучше не использовать и не ставить, по программным требованиям получается совмещение несовместимого, всё ломается.
Лучше да, через kohya_ss gui
(но вы понимаете, да, 80% успеха вы достигли, остальные 15% потребуют 80% усилий).
Цитата: Сергей от 07.03.2023, 18:20see3, спасибо огромное за информацию 👍! Единственное - боюсь полную модель не вывезу (в том смысле что не уверен что она мне нужна), хотелось бы сделать максимально универсальную Лору/гиперсеть, и тут, вероятно, копать надо все таки в сторону датасета\описаний ┐('~`;)┌.
see3, спасибо огромное за информацию 👍! Единственное - боюсь полную модель не вывезу (в том смысле что не уверен что она мне нужна), хотелось бы сделать максимально универсальную Лору/гиперсеть, и тут, вероятно, копать надо все таки в сторону датасета\описаний ┐('~`;)┌.
Цитата: Сергей от 07.03.2023, 18:22И еще спросить хотел...DA - это что?
И еще спросить хотел...DA - это что?
Цитата: see3 от 07.03.2023, 18:24Deviant Art (если не знали, то лучше и не знать, одни извращенцы там =) )
Deviant Art (если не знали, то лучше и не знать, одни извращенцы там =) )
Цитата: Сергей от 07.03.2023, 18:38see3, мне кажется мой мозг скоро лопнет от переизбытка информации =) надо взять таймаут, так глубоко копать мне может и не нужно, я все таки работаю совсем не в сфере дизайна/рекламы и тд =) это так...хобби, зацепила тема
see3, мне кажется мой мозг скоро лопнет от переизбытка информации =) надо взять таймаут, так глубоко копать мне может и не нужно, я все таки работаю совсем не в сфере дизайна/рекламы и тд =) это так...хобби, зацепила тема
Цитата: see3 от 07.03.2023, 18:43Первые видео Aitrepreneur для того времени (того... с таким развитием, "январь" звучит как что-то доисторическое 🙂 ) были классно мозговзрывающими )
Про controlnet тоже.
У XpucT тоже есть )
Первые видео Aitrepreneur для того времени (того... с таким развитием, "январь" звучит как что-то доисторическое 🙂 ) были классно мозговзрывающими )
Про controlnet тоже.
У XpucT тоже есть )

Цитата: Сергей от 07.03.2023, 18:50Добра)
Скажите, а как можно расширить изображение сгенерированное нейросеткой, при помощи нейросетки?))) Я пытался делать так, как учили в видео, но ничего не выходит. Не выходит по тому, что я не могу задать нужный промт.
Картинка 1
Картинка получилась в результате совокупления двух промтов : [girl:boy:10] все.Но арт получился красивый и я хотел сделать его на рабочку, для чего попытался расшить его примерно до 2500 х1400 в img2img. Но так как я представления не имею что это у девушки вместо волос, я не могу ввести нужный промт.
Получается одна фигня.
Картинка 2
Перебрал кучу промтов и даже пытался довериться самой сетке, не указывая вообще ничего, мол, сама додумай. Додумывала хреново. Не так, как надо.
А мне нужно что бы картинка смотртелась гармонично и края ее (расширяемые) были логическим продолжением исходника.
В общем.. Помощи прошу)) Научите расскажите объясните )))
Спасибо))
Добра)
Скажите, а как можно расширить изображение сгенерированное нейросеткой, при помощи нейросетки?))) Я пытался делать так, как учили в видео, но ничего не выходит. Не выходит по тому, что я не могу задать нужный промт.
Картинка 1
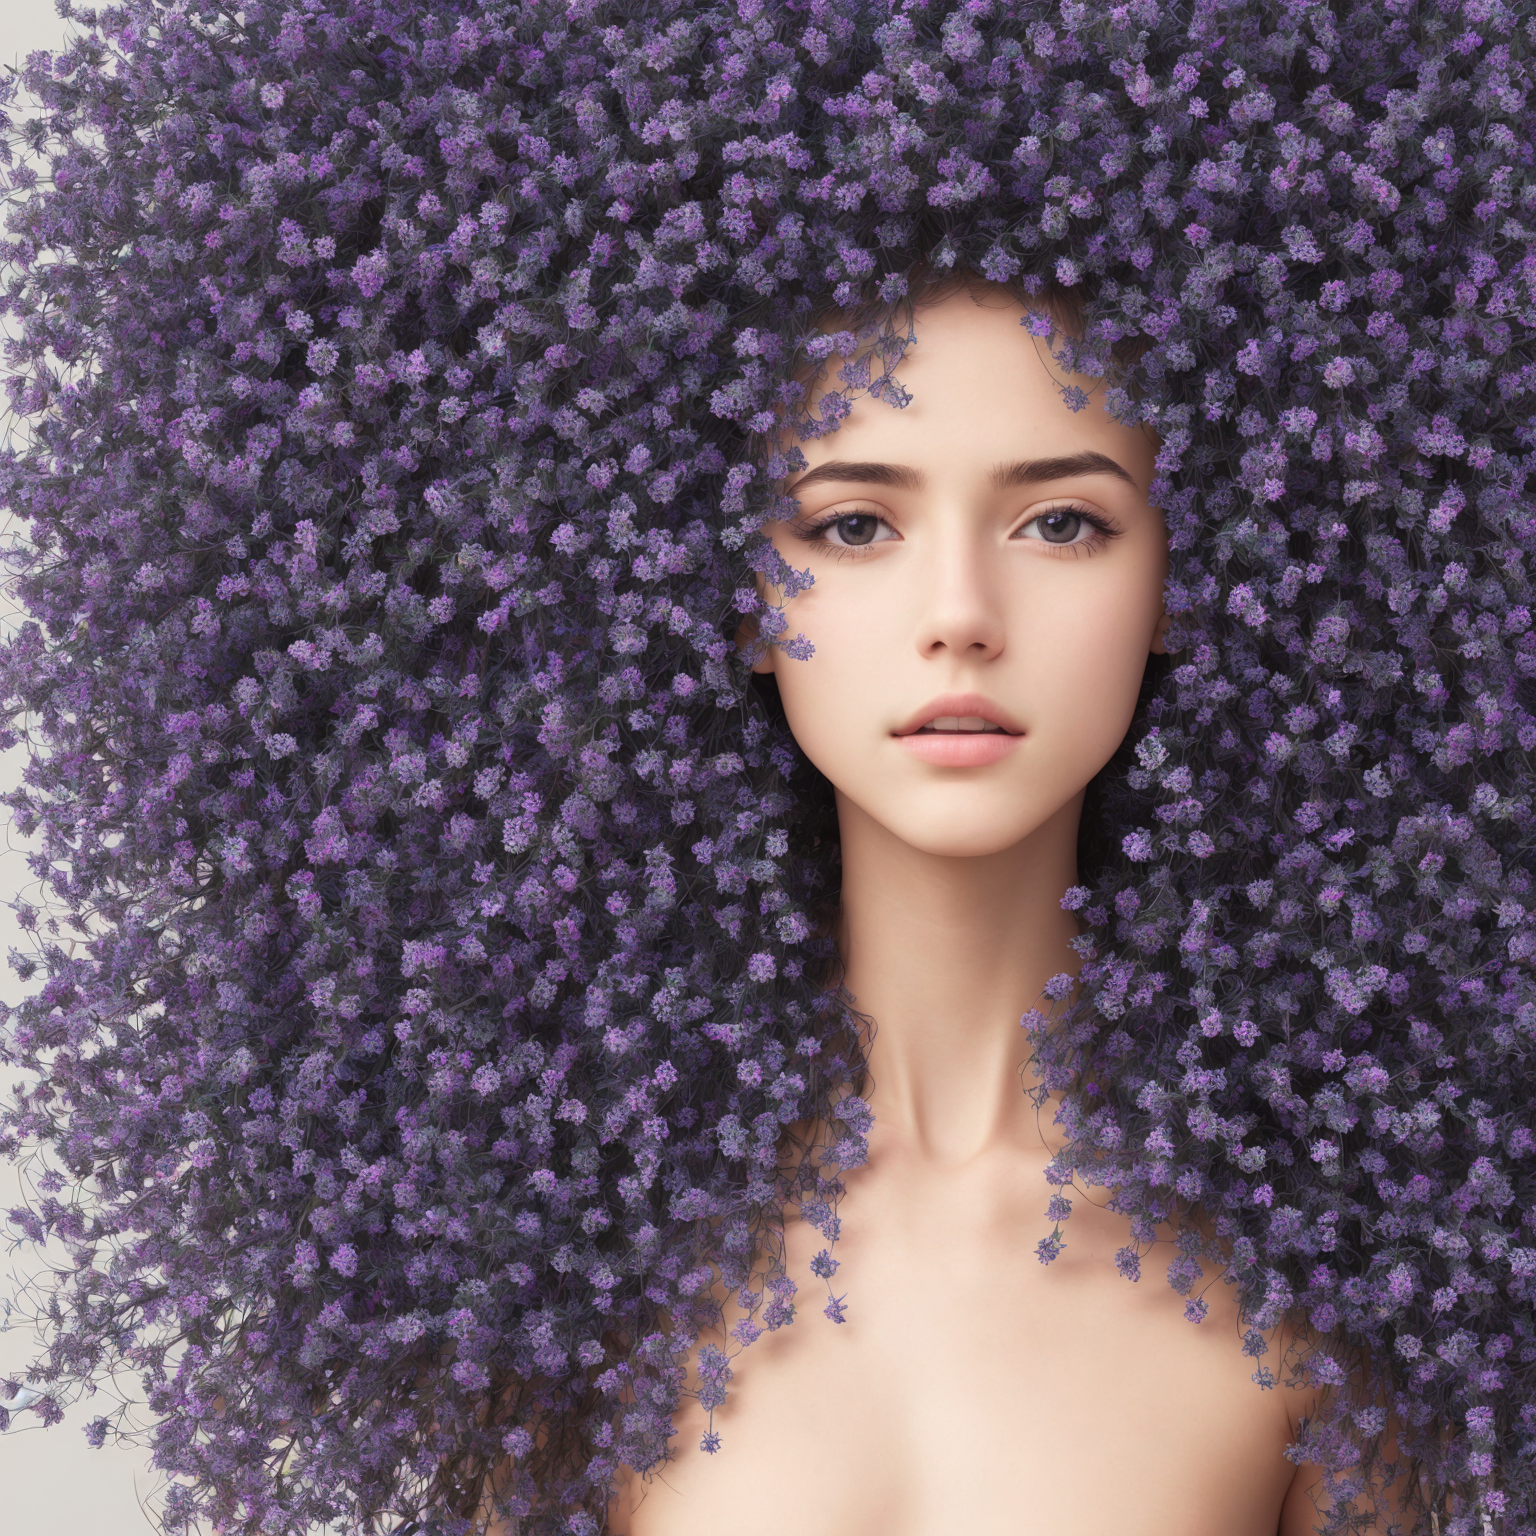
Картинка получилась в результате совокупления двух промтов : [girl:boy:10] все.
Но арт получился красивый и я хотел сделать его на рабочку, для чего попытался расшить его примерно до 2500 х1400 в img2img. Но так как я представления не имею что это у девушки вместо волос, я не могу ввести нужный промт.
Получается одна фигня.
Картинка 2

Перебрал кучу промтов и даже пытался довериться самой сетке, не указывая вообще ничего, мол, сама додумай. Додумывала хреново. Не так, как надо.
А мне нужно что бы картинка смотртелась гармонично и края ее (расширяемые) были логическим продолжением исходника.
В общем.. Помощи прошу)) Научите расскажите объясните )))
Спасибо))

Цитата: Игорь от 07.03.2023, 19:05Сергей, приветствую 🖐
Настоятельно рекомендую посмотреть следующие видео.
Как оформлять свои темы и комментарии | Как делать крутые скриншоты
Сергей, приветствую 🖐
Настоятельно рекомендую посмотреть следующие видео.
Как оформлять свои темы и комментарии | Как делать крутые скриншоты

Цитата: Андрей от 07.03.2023, 21:50Цитата: see3 от 07.03.2023, 17:05Сергей,
из японского описания,
[spoiler title=""]
There are the following methods (each name is not a general one, but a definition unique to this repository). Regularized images will be discussed later.
DreamBooth, class+identifier method (regularized portrait can be used)
Learn to associate the learning object with a specific word (identifier). No need to provide captions. For example, if you use it to learn a specific character, you don't need to prepare captions, so it's easy, but all elements of the learning data such as hairstyles, clothes, and backgrounds are learned by being linked to identifiers. There may be situations where you can't change clothes at the prompt.
DreamBooth, captioning method (canonicalized images can be used)
Prepare and study a text file in which captions are recorded for each image. For example, when learning a specific character, by describing the details of the image in the caption (character A in white clothes, character A in red clothes, etc.), the character and other elements are separated, making it more precise You can expect the model to learn only the character at the time.[/spoiler]
Как раз ваш случай. При обучении без аннотации может получиться так, что причёска, одежда и т.д. будут привязаны к обьекту и их будет не поменять промптом.
Для этого нужен DreamBooth с аннотацией. Как я понимаю, указываемые теги не то что отделяются от обьекта, скорее модель учится использовать указанные теги одновременно с обьектом отдельно от него самого (укажете red dress - будет знать что красное платье на обьекте выглядит именно так. Ни разу не укажете цветы - не будет знать, как обьект обращается с цветами, только как это у его класса, из базовой модели).
Изображения класса надо использовать, улучшают выделение конкретного обьекта из общей массы (узнаваемость).
Я обычно использую заранее сгенерированные картинки, для класса woman - по промпту photo of a woman / photo of caucasian woman (штук 400-500 достаточно) - могу их выложить.
Для DreamBooth число шагов лучше укладывать в 1600-2000, т.е. число повторов указать (1600 - 2000)*batch_size/(2*samples) (*2 - от изображений класса). От этого числа зависит, как семплы поделятся по корзинам, при их использовании (и от batch_size тоже), поэтому качество трейна будет рандомно скакать - подобрать его на свой размер датасета. (Для класса указать повтор = 1, в названии папки 1_class или через basic caption сделать всем одинаковую аннотацию).
Но вот при использовании корзин и без ограничения их размера - начинает трейнить на 768*1024, типа того, и использование памяти улетает далеко за 12гб,
тут остаются только видеокарты 3090/4090 ...По поводу одежды и описаний при трейне: да, иногда это проблема. Не рекомендуется делать сет в одной и той же одежде. А если все же в одежде (в одной), можно ли схитрить: сделать описание: man in trenning dress. И если мы не указываем в промпте это, или пишем другая dress, то он поймёт, что нужно сменить одежду? Как его проще заставить это сделать, если я был везде в синей рубашке в горошек (условно)?:)
Цитата: see3 от 07.03.2023, 17:05Сергей,
из японского описания,
Спойлер
There are the following methods (each name is not a general one, but a definition unique to this repository). Regularized images will be discussed later.
DreamBooth, class+identifier method (regularized portrait can be used)
Learn to associate the learning object with a specific word (identifier). No need to provide captions. For example, if you use it to learn a specific character, you don't need to prepare captions, so it's easy, but all elements of the learning data such as hairstyles, clothes, and backgrounds are learned by being linked to identifiers. There may be situations where you can't change clothes at the prompt.
DreamBooth, captioning method (canonicalized images can be used)
Prepare and study a text file in which captions are recorded for each image. For example, when learning a specific character, by describing the details of the image in the caption (character A in white clothes, character A in red clothes, etc.), the character and other elements are separated, making it more precise You can expect the model to learn only the character at the time.
Как раз ваш случай. При обучении без аннотации может получиться так, что причёска, одежда и т.д. будут привязаны к обьекту и их будет не поменять промптом.
Для этого нужен DreamBooth с аннотацией. Как я понимаю, указываемые теги не то что отделяются от обьекта, скорее модель учится использовать указанные теги одновременно с обьектом отдельно от него самого (укажете red dress - будет знать что красное платье на обьекте выглядит именно так. Ни разу не укажете цветы - не будет знать, как обьект обращается с цветами, только как это у его класса, из базовой модели).
Изображения класса надо использовать, улучшают выделение конкретного обьекта из общей массы (узнаваемость).
Я обычно использую заранее сгенерированные картинки, для класса woman - по промпту photo of a woman / photo of caucasian woman (штук 400-500 достаточно) - могу их выложить.
Для DreamBooth число шагов лучше укладывать в 1600-2000, т.е. число повторов указать (1600 - 2000)*batch_size/(2*samples) (*2 - от изображений класса). От этого числа зависит, как семплы поделятся по корзинам, при их использовании (и от batch_size тоже), поэтому качество трейна будет рандомно скакать - подобрать его на свой размер датасета. (Для класса указать повтор = 1, в названии папки 1_class или через basic caption сделать всем одинаковую аннотацию).
Но вот при использовании корзин и без ограничения их размера - начинает трейнить на 768*1024, типа того, и использование памяти улетает далеко за 12гб,
тут остаются только видеокарты 3090/4090 ...
По поводу одежды и описаний при трейне: да, иногда это проблема. Не рекомендуется делать сет в одной и той же одежде. А если все же в одежде (в одной), можно ли схитрить: сделать описание: man in trenning dress. И если мы не указываем в промпте это, или пишем другая dress, то он поймёт, что нужно сменить одежду? Как его проще заставить это сделать, если я был везде в синей рубашке в горошек (условно)?:)