

Stable Diffusion

Цитата: k0les0 от 01.05.2023, 16:39Помогите с решением проблемы пожалуйста. Удалял в папке ➜
...\stable-diffusion-portable-main\models\BLIPвсе файлы , не помогает[spoiler title=""]Error interrogating
Traceback (most recent call last):
File "F:\stable-diffusion-portable-main\modules\interrogate.py", line 196, in interrogate
self.load()
File "F:\stable-diffusion-portable-main\modules\interrogate.py", line 123, in load
self.blip_model = self.load_blip_model()
File "F:\stable-diffusion-portable-main\modules\interrogate.py", line 103, in load_blip_model
blip_model = models.blip.blip_decoder(pretrained=files[0], image_size=blip_image_eval_size, vit='base', med_config=os.path.join(paths.paths["BLIP"], "configs", "med_config.json"))
File "F:\stable-diffusion-portable-main\repositories\BLIP\models\blip.py", line 175, in blip_decoder
model,msg = load_checkpoint(model,pretrained)
File "F:\stable-diffusion-portable-main\repositories\BLIP\models\blip.py", line 224, in load_checkpoint
state_dict = checkpoint['model']
TypeError: 'NoneType' object is not subscriptable[/spoiler]
Помогите с решением проблемы пожалуйста. Удалял в папке ➜ ...\stable-diffusion-portable-main\models\BLIP все файлы , не помогает
Traceback (most recent call last):
File "F:\stable-diffusion-portable-main\modules\interrogate.py", line 196, in interrogate
self.load()
File "F:\stable-diffusion-portable-main\modules\interrogate.py", line 123, in load
self.blip_model = self.load_blip_model()
File "F:\stable-diffusion-portable-main\modules\interrogate.py", line 103, in load_blip_model
blip_model = models.blip.blip_decoder(pretrained=files[0], image_size=blip_image_eval_size, vit='base', med_config=os.path.join(paths.paths["BLIP"], "configs", "med_config.json"))
File "F:\stable-diffusion-portable-main\repositories\BLIP\models\blip.py", line 175, in blip_decoder
model,msg = load_checkpoint(model,pretrained)
File "F:\stable-diffusion-portable-main\repositories\BLIP\models\blip.py", line 224, in load_checkpoint
state_dict = checkpoint['model']
TypeError: 'NoneType' object is not subscriptable

Цитата: Сергей от 01.05.2023, 17:31Я так понимаю что на колаб SD уже не работает?
Я так понимаю что на колаб SD уже не работает?

Цитата: Никита от 01.05.2023, 19:04Всем привет!
Делюсь наблюдением. Сегодня обновил torch и x-formers.
Ускорение генерации в два раза на 4090, а апскейл это вообще что-то абсурдное.
[spoiler title="Скирн"][/spoiler]
4x за 4 секунды. С учётом того, что я делал этот апскейл в процессе записи видео через OBS в 2к разрешении.
Обнова огонь!
Всем привет!
Делюсь наблюдением. Сегодня обновил torch и x-formers.
Ускорение генерации в два раза на 4090, а апскейл это вообще что-то абсурдное.
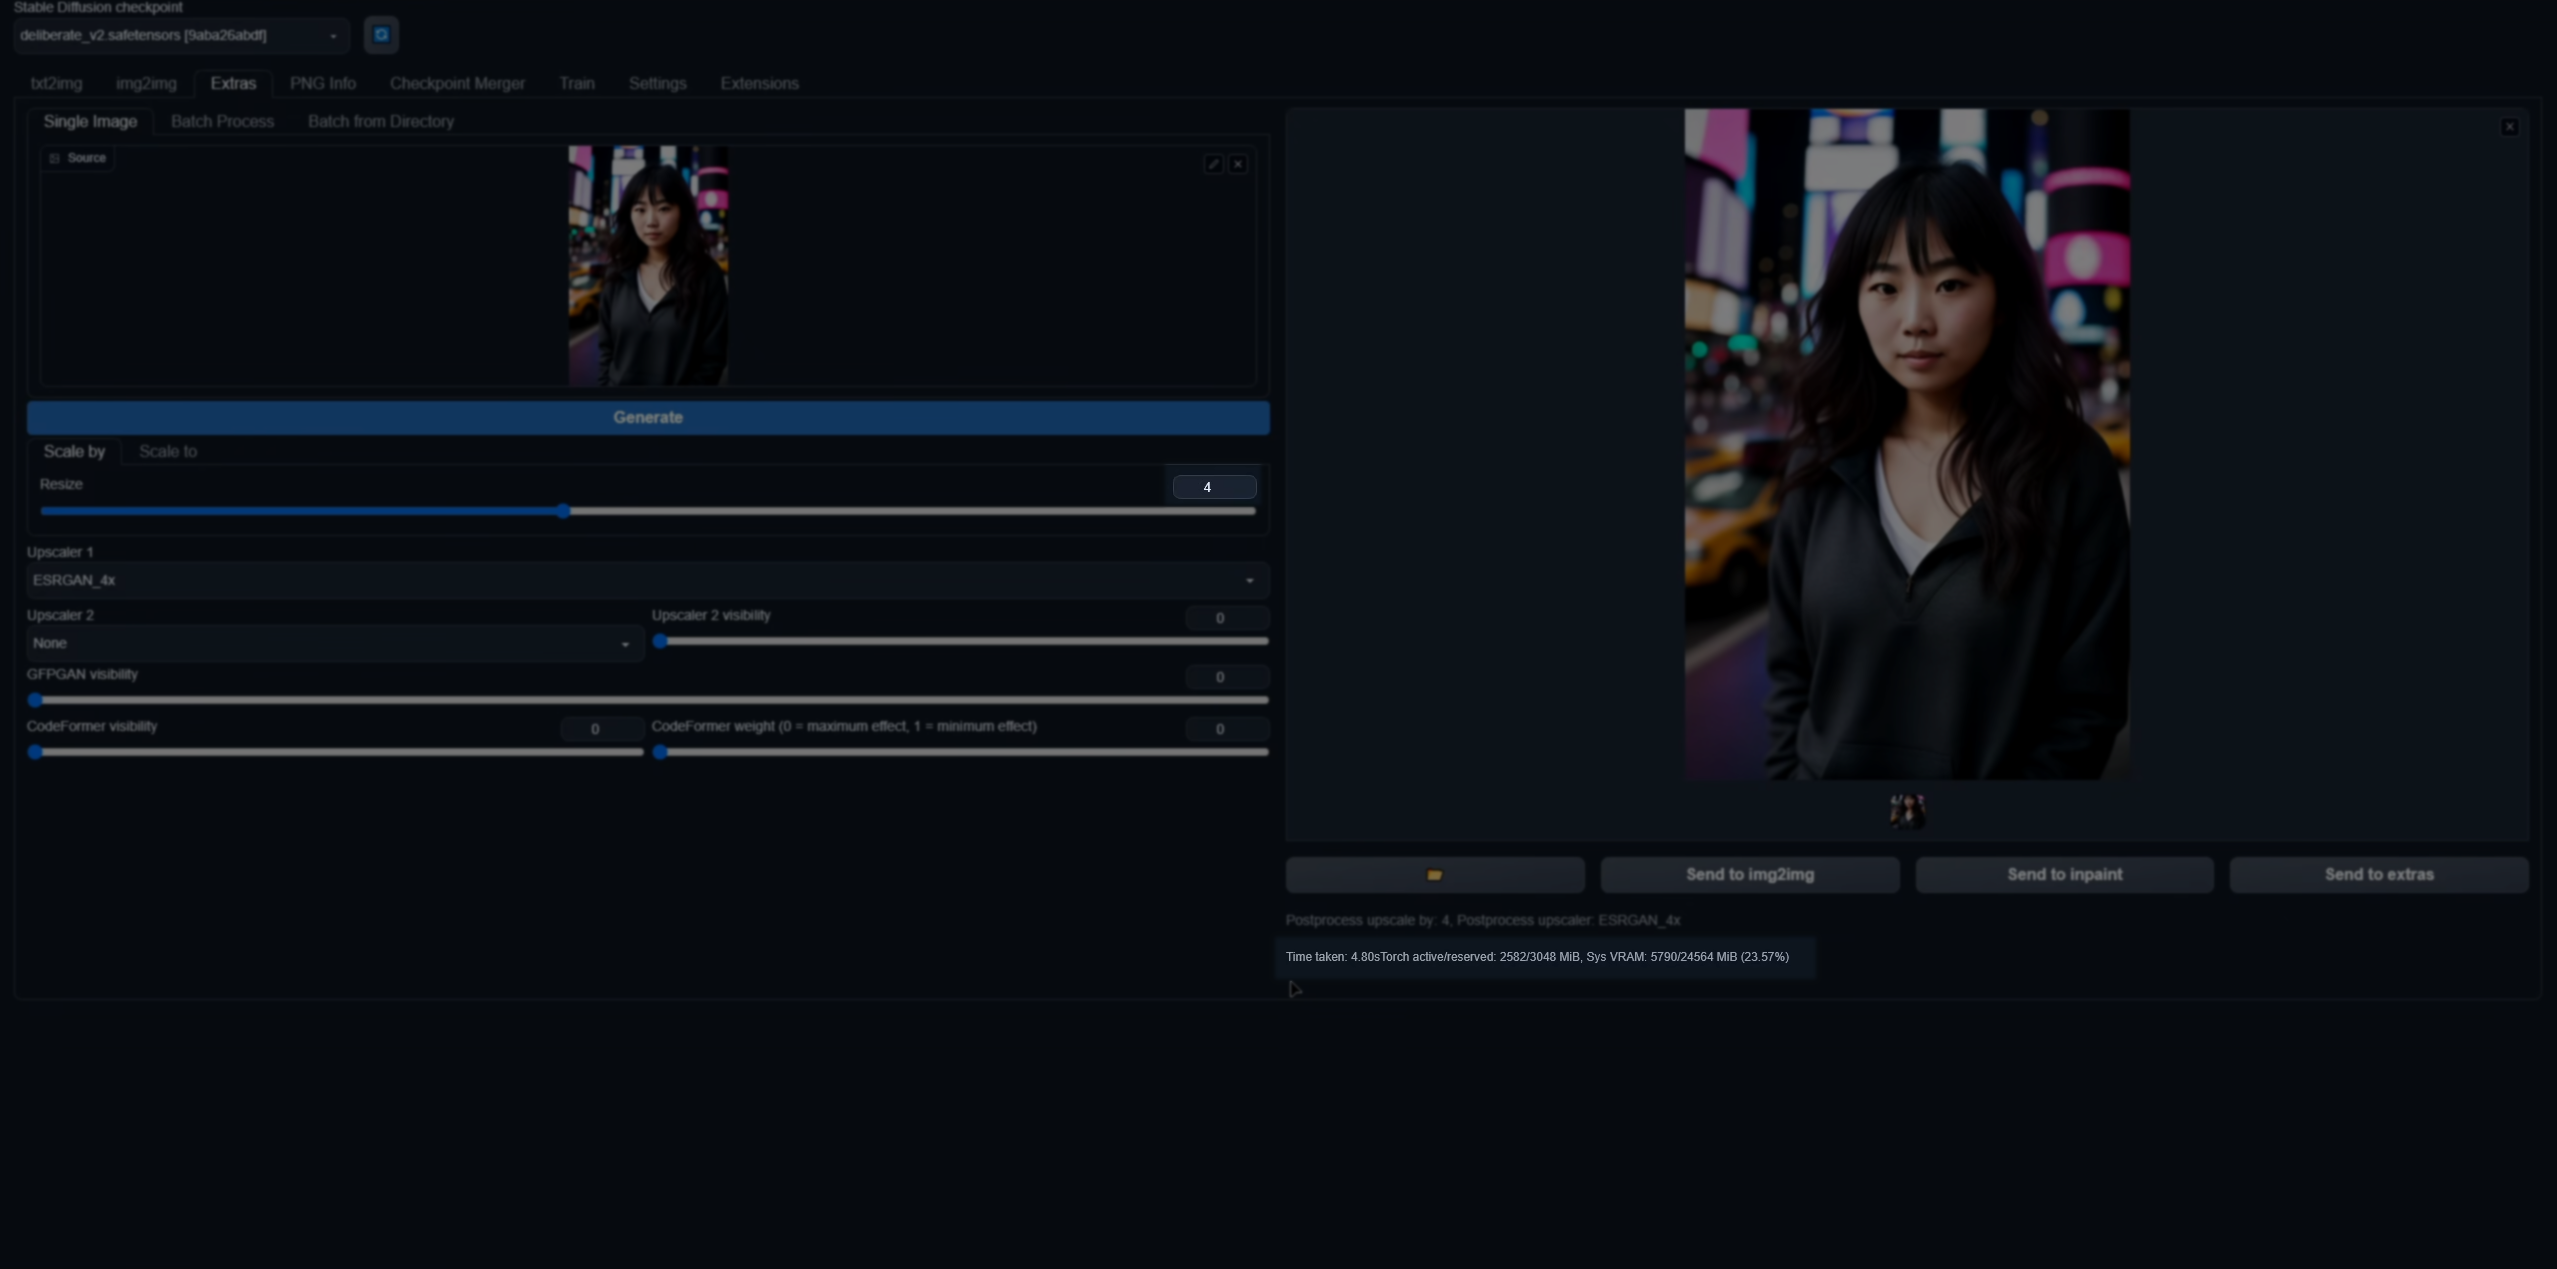
4x за 4 секунды. С учётом того, что я делал этот апскейл в процессе записи видео через OBS в 2к разрешении.
Обнова огонь!


Цитата: Сергей от 01.05.2023, 19:06Никита, привет 🖐
Ты, похоже, до этого не ставил cuDNN. Сейчас он по умолчанию встроен в Torch 2.0, поэтому скорость =)
Никита, привет 🖐
Ты, похоже, до этого не ставил cuDNN. Сейчас он по умолчанию встроен в Torch 2.0, поэтому скорость =)

Цитата: Alex от 01.05.2023, 23:02При загрузке и попытке сменить чекпоинт выдает ошибку и дальше вообще не работает.
File "G:\stable-diffusion\modules\sd_models.py", line 206, in get_state_dict_from_checkpoint
pl_sd = pl_sd.pop("state_dict", pl_sd)
AttributeError: 'NoneType' object has no attribute 'pop'В чем может быть причина?
При загрузке и попытке сменить чекпоинт выдает ошибку и дальше вообще не работает.
File "G:\stable-diffusion\modules\sd_models.py", line 206, in get_state_dict_from_checkpoint
pl_sd = pl_sd.pop("state_dict", pl_sd)
AttributeError: 'NoneType' object has no attribute 'pop'
В чем может быть причина?

Цитата: Roman от 02.05.2023, 04:50torch 2.0 убил возможность использования видеокарт с 4gb (раньше рисовалось в разрешении 1280х1280, сейчас 512х512 это потолок)
torch 2.0 убил возможность использования видеокарт с 4gb (раньше рисовалось в разрешении 1280х1280, сейчас 512х512 это потолок)
Цитата: k0les0 от 02.05.2023, 11:55Цитата: Никита от 01.05.2023, 19:04Всем привет!
Делюсь наблюдением. Сегодня обновил torch и x-formers.
Ускорение генерации в два раза на 4090, а апскейл это вообще что-то абсурдное.
[spoiler title="Скирн"]<img class="lazyload " src="data:;base64," alt="" width="1022" height="507" data-orig-src="https://i.ibb.co/Gn10Yn6/7cbdde37d0a0.png" />[/spoiler]
4x за 4 секунды. С учётом того, что я делал этот апскейл в процессе записи видео через OBS в 2к разрешении.
Обнова огонь!а как обновить torch и x-formers?
Цитата: Никита от 01.05.2023, 19:04Всем привет!
Делюсь наблюдением. Сегодня обновил torch и x-formers.
Ускорение генерации в два раза на 4090, а апскейл это вообще что-то абсурдное.
Скирн<img class="lazyload " src="data:;base64," alt="" width="1022" height="507" data-orig-src="https://i.ibb.co/Gn10Yn6/7cbdde37d0a0.png" style="color: #25d39d !important" />
4x за 4 секунды. С учётом того, что я делал этот апскейл в процессе записи видео через OBS в 2к разрешении.
Обнова огонь!
а как обновить torch и x-formers?

Цитата: Андрей от 02.05.2023, 13:01Цитата: Alex от 29.04.2023, 16:51Подскажите, что дает более качественные результаты с моделями (в первую очередь, людей) - Lora или Тrain\Dreamboot?
Или есть особенности использования для разных целей?
Разница во времени тренировки все-таки очень существенная.В теории так: Dreambooth, Lora, Hypernetwork
Hypernetwork - я бы сказал, для тренировки лиц людей не подходит толком. Персонажи, ещё может быть
Lora дает хорошие результаты, но очень критична к датасету и параметрам. Иногда получается хорошо, иногда не очень, и понять почему не всегда удается
Dreambooth - я его собираюсь опробовать, но пока не срослось. Он требует больше ресурсов машины, мне нужно всё настроить. Лора в этом плане хороша и удобна
Цитата: Alex от 29.04.2023, 16:51Подскажите, что дает более качественные результаты с моделями (в первую очередь, людей) - Lora или Тrain\Dreamboot?
Или есть особенности использования для разных целей?
Разница во времени тренировки все-таки очень существенная.
В теории так: Dreambooth, Lora, Hypernetwork
Hypernetwork - я бы сказал, для тренировки лиц людей не подходит толком. Персонажи, ещё может быть
Lora дает хорошие результаты, но очень критична к датасету и параметрам. Иногда получается хорошо, иногда не очень, и понять почему не всегда удается
Dreambooth - я его собираюсь опробовать, но пока не срослось. Он требует больше ресурсов машины, мне нужно всё настроить. Лора в этом плане хороша и удобна
Цитата: Андрей от 02.05.2023, 13:06Цитата: Alex от 30.04.2023, 09:59Создал две модели с помощью Лоры.
В одном очень качественные исходники - фото все отличные - 90 штук.
Вторая - фото средние, в количестве 30 шт.
В итоге в СД практически никакого портретного сходства - получаются уродливые миксы. Похожесть процентов 20.
Например, на Колабе ,на модели на основе 80 фото с телефона, где качество очень среднее, по Дримбутчу выдает чудеса - красивейшие портреты и прочее.
Куда смотреть, ведь по отзывам Лора должна выдавать хороший результат, а то, что получается, вообще использовать невозможно.Какими параметрами тренировали Dreambooth на колабе и какими Лору? Использование рег картинок в Лоре может улучшить результат
Цитата: Alex от 30.04.2023, 09:59Создал две модели с помощью Лоры.
В одном очень качественные исходники - фото все отличные - 90 штук.
Вторая - фото средние, в количестве 30 шт.
В итоге в СД практически никакого портретного сходства - получаются уродливые миксы. Похожесть процентов 20.
Например, на Колабе ,на модели на основе 80 фото с телефона, где качество очень среднее, по Дримбутчу выдает чудеса - красивейшие портреты и прочее.
Куда смотреть, ведь по отзывам Лора должна выдавать хороший результат, а то, что получается, вообще использовать невозможно.
Какими параметрами тренировали Dreambooth на колабе и какими Лору? Использование рег картинок в Лоре может улучшить результат
Цитата: Alex от 02.05.2023, 16:13Lora дает хорошие результаты, но очень критична к датасету и параметрам. Иногда получается хорошо, иногда не очень, и понять почему не всегда удается
Вот тоже хотелось бы ясности. Даже по датасетам так и нет единого мнения.
Изначально говорилось, что более 30 фото вообще не нужно, потом появились мнения, что и более вполне приемлемо. То же качается ракурсов и дистанций - то ли это улучшает результаты, то ли сбивает сеть с толку и она ухудшает общий показатель, основанный на хороших крупных портретах. Странно, что нет точных инструкций по использованию программы.
Lora дает хорошие результаты, но очень критична к датасету и параметрам. Иногда получается хорошо, иногда не очень, и понять почему не всегда удается
Вот тоже хотелось бы ясности. Даже по датасетам так и нет единого мнения.
Изначально говорилось, что более 30 фото вообще не нужно, потом появились мнения, что и более вполне приемлемо. То же качается ракурсов и дистанций - то ли это улучшает результаты, то ли сбивает сеть с толку и она ухудшает общий показатель, основанный на хороших крупных портретах. Странно, что нет точных инструкций по использованию программы.
Цитата: Alex от 02.05.2023, 16:20Цитата: Андрей от 02.05.2023, 13:06
Какими параметрами тренировали Dreambooth на колабе и какими Лору? Использование рег картинок в Лоре может улучшить результат
Dreambooth делал всё по умолчанию, единственное, что менял, - ставил 200 шагов на фото и выбрал 1.5 модель. Все остальное по дефолту в Колабе.
Насчет Лоры, как оказалось, сделал неправильно. Настройки по видео Христа о ЛОРЕ, но я не выставил параметры узнаваемости, они почему-то стояли на 8, хотя должны были на 128. И кейвордс установил на 150, что, видимо, много. Советуют только 100. В общем, проведу перетернировку и сравню.
А картинки нужно именно генерить в СД?
Я пытался как-то подсунуть папку с обычными фото 512 на 512 - програма их не увидела и стала создавать свои кривые карикатуры с хешами из букв и цифр.
У меня на Dreambooth ошибка CUDA, я так и не нашел ответа как запустить на 8 Гб ГПУ...
Цитата: Андрей от 02.05.2023, 13:06
Какими параметрами тренировали Dreambooth на колабе и какими Лору? Использование рег картинок в Лоре может улучшить результат
Dreambooth делал всё по умолчанию, единственное, что менял, - ставил 200 шагов на фото и выбрал 1.5 модель. Все остальное по дефолту в Колабе.
Насчет Лоры, как оказалось, сделал неправильно. Настройки по видео Христа о ЛОРЕ, но я не выставил параметры узнаваемости, они почему-то стояли на 8, хотя должны были на 128. И кейвордс установил на 150, что, видимо, много. Советуют только 100. В общем, проведу перетернировку и сравню.
А картинки нужно именно генерить в СД?
Я пытался как-то подсунуть папку с обычными фото 512 на 512 - програма их не увидела и стала создавать свои кривые карикатуры с хешами из букв и цифр.
У меня на Dreambooth ошибка CUDA, я так и не нашел ответа как запустить на 8 Гб ГПУ...
Цитата: Андрей от 03.05.2023, 10:34Цитата: Alex от 02.05.2023, 16:20Цитата: Андрей от 02.05.2023, 13:06
Какими параметрами тренировали Dreambooth на колабе и какими Лору? Использование рег картинок в Лоре может улучшить результат
Dreambooth делал всё по умолчанию, единственное, что менял, - ставил 200 шагов на фото и выбрал 1.5 модель. Все остальное по дефолту в Колабе.
Насчет Лоры, как оказалось, сделал неправильно. Настройки по видео Христа о ЛОРЕ, но я не выставил параметры узнаваемости, они почему-то стояли на 8, хотя должны были на 128. И кейвордс установил на 150, что, видимо, много. Советуют только 100. В общем, проведу перетернировку и сравню.
А картинки нужно именно генерить в СД?
Я пытался как-то подсунуть папку с обычными фото 512 на 512 - програма их не увидела и стала создавать свои кривые карикатуры с хешами из букв и цифр.
У меня на Dreambooth ошибка CUDA, я так и не нашел ответа как запустить на 8 Гб ГПУ...Да, картинки рекомендую в SD генерировать. И ещё. Ставь косинус 120 шагов. Остальные настройки можешь оставить в Лоре
Цитата: Alex от 02.05.2023, 16:20Цитата: Андрей от 02.05.2023, 13:06
Какими параметрами тренировали Dreambooth на колабе и какими Лору? Использование рег картинок в Лоре может улучшить результат
Dreambooth делал всё по умолчанию, единственное, что менял, - ставил 200 шагов на фото и выбрал 1.5 модель. Все остальное по дефолту в Колабе.
Насчет Лоры, как оказалось, сделал неправильно. Настройки по видео Христа о ЛОРЕ, но я не выставил параметры узнаваемости, они почему-то стояли на 8, хотя должны были на 128. И кейвордс установил на 150, что, видимо, много. Советуют только 100. В общем, проведу перетернировку и сравню.
А картинки нужно именно генерить в СД?
Я пытался как-то подсунуть папку с обычными фото 512 на 512 - програма их не увидела и стала создавать свои кривые карикатуры с хешами из букв и цифр.
У меня на Dreambooth ошибка CUDA, я так и не нашел ответа как запустить на 8 Гб ГПУ...
Да, картинки рекомендую в SD генерировать. И ещё. Ставь косинус 120 шагов. Остальные настройки можешь оставить в Лоре
Цитата: Alex от 03.05.2023, 11:13Цитата: Андрей от 02.05.2023, 13:01Lora дает хорошие результаты, но очень критична к датасету и параметрам. Иногда получается хорошо, иногда не очень, и понять почему не всегда удается
Провел повторную тренировку на Лоре.
Датасет с 30 фото, 100 шагов, 128/128, 1 эпоха.
Узнаваемость персонажа есть, но получаются нормально только крупные портреты в художественной обработке. Просто фото, даже крупные, чаще всего получаются кринжово. Средние почти всегда хреново. Результат намного лучше первых попыток, но до нормы еще далеко.Датасет на 90 фото.
Те же настройки. Узнаваемость значительно повысилась, но, думаю, что перетренировка на выходе - лицо сначала делает нормальным, потом плющит и делает либо слишком старым либо частично деформированным. Тут перетренировка из-за количества фото возможно. Или для большего количества нужно менять настройки, нок ак они влияют я пока не понял.
Тренинг без описаний и без регуляризационных картинок ( \с ними что-то ошибку выбивало, нужно разбираться)
Как вообще недотренировку отличить от перетренировки?
Цитата: Андрей от 02.05.2023, 13:01
Lora дает хорошие результаты, но очень критична к датасету и параметрам. Иногда получается хорошо, иногда не очень, и понять почему не всегда удается
Провел повторную тренировку на Лоре.
Датасет с 30 фото, 100 шагов, 128/128, 1 эпоха.
Узнаваемость персонажа есть, но получаются нормально только крупные портреты в художественной обработке. Просто фото, даже крупные, чаще всего получаются кринжово. Средние почти всегда хреново. Результат намного лучше первых попыток, но до нормы еще далеко.
Датасет на 90 фото.
Те же настройки. Узнаваемость значительно повысилась, но, думаю, что перетренировка на выходе - лицо сначала делает нормальным, потом плющит и делает либо слишком старым либо частично деформированным. Тут перетренировка из-за количества фото возможно. Или для большего количества нужно менять настройки, нок ак они влияют я пока не понял.
Тренинг без описаний и без регуляризационных картинок ( \с ними что-то ошибку выбивало, нужно разбираться)
Как вообще недотренировку отличить от перетренировки?
Цитата: Alex от 03.05.2023, 13:00Цитата: Андрей от 03.05.2023, 10:34Да, картинки рекомендую в SD генерировать. И ещё. Ставь косинус 120 шагов. Остальные настройки можешь оставить в Лоре
Косинус - это кейвордс или Network rank?
Цитата: Андрей от 03.05.2023, 10:34Да, картинки рекомендую в SD генерировать. И ещё. Ставь косинус 120 шагов. Остальные настройки можешь оставить в Лоре
Косинус - это кейвордс или Network rank?